ഒപ്റ്റിക്കൽ ക്യാരക്ടർ റെക്കഗ്നിഷൻ ഇപ്പോൾ രസീത് സ്കാനിംഗ്, ഐഡി വെരിഫിക്കേഷൻ, ഇൻവോയ്സ് ഓട്ടോമേഷൻ, ഹിസ്റ്റോറിക്കൽ ആർക്കൈവ് ഡിജിറ്റൈസേഷൻ, സ്റ്റൈലസ് അധിഷ്ഠിത നോട്ട് ആപ്പുകൾ എന്നിവയ്ക്ക് ശക്തി നൽകുന്നു. 2030 ആകുമ്പോഴേക്കും OCR വിപണി 14.8% CAGR (ഗ്രാൻഡ് വ്യൂ റിസർച്ച്, 2024) ൽ 32.90 ബില്യൺ ഡോളറിലെത്തുമെന്ന് പ്രതീക്ഷിക്കുന്നു, ഇന്റലിജന്റ് ക്യാരക്ടർ റെക്കഗ്നിഷൻ - OCR-ന്റെ ഹാൻഡ്റൈറ്റിംഗ്-റീഡിംഗ് ബ്രാഞ്ച് - വേഗത്തിൽ വളരുന്നു. നിങ്ങൾ ഡോക്യുമെന്റ് പാഴ്സിംഗ്, സീൻ-ടെക്സ്റ്റ് ഡിറ്റക്ഷൻ, അല്ലെങ്കിൽ ഹാൻഡ്റൈറ്റിംഗ് ട്രാൻസ്ക്രിപ്ഷൻ എന്നിവ നിർമ്മിക്കുകയാണെങ്കിലും, നിങ്ങൾ പരിശീലിപ്പിക്കുന്ന OCR ഡാറ്റാസെറ്റ് നിങ്ങളുടെ കൃത്യത പരിധി സജ്ജമാക്കുന്നു. ഈ ഗൈഡ് 22 സൗജന്യ, ഓപ്പൺ സോഴ്സ് OCR ഡാറ്റാസെറ്റുകൾ ഉൾക്കൊള്ളുന്നു - മികച്ച ഹാൻഡ്റൈറ്റിംഗ് ഡാറ്റാസെറ്റുകൾ ഉൾപ്പെടെ - ഉപയോഗ കേസ് അനുസരിച്ച് ക്രമീകരിച്ച് 2024 വരെ ഏറ്റവും ശക്തമായ റിലീസുകൾ ഉപയോഗിച്ച് പുതുക്കിയിരിക്കുന്നു.
കീ ടേക്ക്അവേസ്
- OCR (ഒപ്റ്റിക്കൽ ക്യാരക്ടർ റെക്കഗ്നിഷൻ): അച്ചടിച്ച, ദൃശ്യമായ അല്ലെങ്കിൽ കൈയക്ഷര വാചകങ്ങളുടെ ചിത്രങ്ങൾ മെഷീൻ വായിക്കാവുന്ന ഡാറ്റയാക്കി മാറ്റുന്ന സാങ്കേതികവിദ്യ.
- OCR ഡാറ്റാസെറ്റുകൾ അഞ്ച് ഗ്രൂപ്പുകളായി തിരിച്ചിരിക്കുന്നു: ഡോക്യുമെന്റ്/ഫോം, സീൻ ടെക്സ്റ്റ്, അക്കം/പ്രതീകം, കൈയക്ഷരം, ബഹുഭാഷ.
- ഡോക്യുമെന്റ് OCR ഡാറ്റാസെറ്റുകൾ ഫോമുകൾ, രസീതുകൾ പോലുള്ള ഘടനാപരമായ പേജുകൾ ക്യാപ്ചർ ചെയ്യുക; സീൻ-ടെക്സ്റ്റ് ഡാറ്റാസെറ്റുകൾ "ഇൻ ദി വൈൽഡ്" എന്ന വാചകം പകർത്തുക.
- IAM, MNIST, ICDAR, SROIE എന്നിവയാണ് ഗവേഷണത്തിലുടനീളം ഏറ്റവും കൂടുതൽ ഉദ്ധരിക്കപ്പെടുന്ന OCR മാനദണ്ഡങ്ങൾ.
- ലൈസൻസ് നിബന്ധനകൾ വ്യാപകമായി വ്യത്യാസപ്പെട്ടിരിക്കുന്നു - വാണിജ്യ പരിശീലനത്തിന് മുമ്പ് ഓരോ OCR ഡാറ്റാസെറ്റും പരിശോധിക്കുക.
എന്താണ് OCR (ഒപ്റ്റിക്കൽ ക്യാരക്ടർ റെക്കഗ്നിഷൻ)?
സ്കാൻ ചെയ്ത പേപ്പർ ഡോക്യുമെൻ്റുകൾ, PDF-കൾ അല്ലെങ്കിൽ ടെക്സ്റ്റിൻ്റെ ഇമേജുകൾ പോലെയുള്ള വ്യത്യസ്ത തരം ഡോക്യുമെൻ്റുകളെ എഡിറ്റ് ചെയ്യാവുന്നതും തിരയാൻ കഴിയുന്നതുമായ ഡാറ്റയാക്കി മാറ്റുന്ന സാങ്കേതികവിദ്യയാണ് OCR. ഇത് പ്രവർത്തിക്കുന്നത്:
- ഒരു ചിത്രത്തിലെ വാചകത്തിൻ്റെ ഘടന വിശകലനം ചെയ്യുന്നു
- വാചകത്തെ വരികളായും പ്രതീകങ്ങളായും വിഭജിക്കുന്നു
- ഈ ദൃശ്യ പ്രതീകങ്ങളെ മെഷീൻ റീഡബിൾ ടെക്സ്റ്റിലേക്ക് പരിവർത്തനം ചെയ്യുന്നു
പൊതുവായ ഉപയോഗങ്ങളിൽ ഇവ ഉൾപ്പെടുന്നു:
- സ്കാൻ ചെയ്ത പ്രമാണങ്ങൾ എഡിറ്റ് ചെയ്യാവുന്ന ടെക്സ്റ്റ് ഫയലുകളാക്കി മാറ്റുന്നു
- അച്ചടിച്ച പുസ്തകങ്ങൾ ഡിജിറ്റൈസ് ചെയ്യുന്നു
- ഫോട്ടോകളിൽ നിന്ന് വാചകം വേർതിരിച്ചെടുക്കുന്നു
- കൈയക്ഷര കുറിപ്പടികൾ ഡിജിറ്റൽ ടെക്സ്റ്റിലേക്ക് മാറ്റുന്നു
- ലൈസൻസ് പ്ലേറ്റ് തിരിച്ചറിയൽ
ശരിയായ OCR ഡാറ്റാസെറ്റ് എങ്ങനെ തിരഞ്ഞെടുക്കാം?
ഒരു OCR ഡാറ്റാസെറ്റ് തിരഞ്ഞെടുക്കുന്നത് നാല് ഘടകങ്ങളെ ആശ്രയിച്ചിരിക്കുന്നു: വാചക തരം, ക്യാപ്ചർ പരിസ്ഥിതി, വ്യാഖ്യാന ഗ്രാനുലാരിറ്റി, ലൈസൻസ്. അച്ചടിച്ച പ്രമാണ OCR-ന് കൈയെഴുത്ത് കഴ്സീവ് അല്ലെങ്കിൽ വളഞ്ഞ രംഗ വാചകത്തിൽ നിന്ന് വ്യത്യസ്തമായ പരിശീലന ഡാറ്റ ആവശ്യമാണ്. ഡോക്യുമെന്റ് ഡാറ്റാസെറ്റുകൾ ഇൻവോയ്സുകൾ, ഫോമുകൾ, രസീതുകൾ എന്നിവയ്ക്ക് അനുയോജ്യമാണ്; സീൻ-ടെക്സ്റ്റ് ഡാറ്റാസെറ്റുകൾ സൈനേജിനും ഉൽപ്പന്ന വായനയ്ക്കും അനുയോജ്യമാണ്; കൈയെഴുത്ത് ഡാറ്റാസെറ്റുകൾ കുറിപ്പുകൾ, കൈയെഴുത്തുപ്രതികൾ, സ്റ്റൈലസ് ഇൻപുട്ട് എന്നിവയ്ക്ക് അനുയോജ്യമാണ്. വേഡ്-ലെവൽ, ലൈൻ-ലെവൽ വ്യാഖ്യാനങ്ങൾ പൂർണ്ണ OCR പൈപ്പ്ലൈനുകളെ പിന്തുണയ്ക്കുന്നു, അതേസമയം പ്രതീക-ലെവൽ സെറ്റുകൾ വർഗ്ഗീകരണ അടിസ്ഥാനങ്ങൾക്ക് അനുയോജ്യമാണ്. ചില OCR ഡാറ്റാസെറ്റുകൾ ഗവേഷണം മാത്രമുള്ളതോ രജിസ്ട്രേഷൻ ആവശ്യമുള്ളതോ ആയതിനാൽ എല്ലായ്പ്പോഴും ലൈസൻസ് നിബന്ധനകൾ സ്ഥിരീകരിക്കുക.
ഏറ്റവും മികച്ച ഡോക്യുമെന്റ്, ഫോം OCR ഡാറ്റാസെറ്റുകൾ ഏതൊക്കെയാണ്?
ഇൻവോയ്സുകൾ, ഫോമുകൾ, രസീതുകൾ, ഐഡികൾ എന്നിവ പോലുള്ള ഘടനാപരമായ പേജുകൾ പാഴ്സ് ചെയ്യാൻ ഡോക്യുമെന്റ് OCR ഡാറ്റാസെറ്റുകൾ മോഡലുകളെ പരിശീലിപ്പിക്കുന്നു. ഇവ ബിസിനസ്സ് ഡോക്യുമെന്റ് ഓട്ടോമേഷനും കീ-വാല്യൂ എക്സ്ട്രാക്ഷനും ശക്തി നൽകുന്നു.
- ഫൺഎസ്ഡി — ശബ്ദായമാനവും യഥാർത്ഥ ലോക രൂപഭാവവുമുള്ള 199 വ്യാഖ്യാനിച്ച സ്കാൻ ചെയ്ത ഫോമുകൾ. ഫോം മനസ്സിലാക്കലിനും കീ-മൂല്യം വേർതിരിച്ചെടുക്കലിനുമുള്ള സ്റ്റാൻഡേർഡ് ബെഞ്ച്മാർക്ക്.
- സ്രോയി — ഒറ്റ സെറ്റിൽ ടെക്സ്റ്റ് കണ്ടെത്തൽ, തിരിച്ചറിയൽ, വിവരങ്ങൾ വേർതിരിച്ചെടുക്കൽ എന്നിവയെ പിന്തുണയ്ക്കുന്ന ഏകദേശം 1,000 രസീതുകളുടെ ICDAR 2019 സ്കാൻ ചെയ്ത-രസീത് ഡാറ്റാസെറ്റ്.
- ചരട് — ഇൻവോയ്സിനും രസീത് ഓട്ടോമേഷനുമുള്ള സമ്പന്നമായ ഫീൽഡ്-ലെവൽ ലേബലുകൾക്കൊപ്പം, പോസ്റ്റ്-ഒസിആർ പാഴ്സിംഗിനായി നിർമ്മിച്ച ഒരു ഏകീകൃത രസീത് ഡാറ്റാസെറ്റ്.
- XFUND — 199 പേജുകൾ വീതമുള്ള ഏഴ് ഭാഷകൾ (ജർമ്മൻ, സ്പാനിഷ്, ഫ്രഞ്ച്, ഇറ്റാലിയൻ, ജാപ്പനീസ്, പോർച്ചുഗീസ്, ചൈനീസ്) ഉൾക്കൊള്ളുന്ന FUNSD യുടെ ബഹുഭാഷാ വിപുലീകരണം. ബഹുഭാഷാ ഡോക്യുമെന്റ് AI-ക്ക് അനുയോജ്യം.
- ഡിഡിഐ-100 — സ്ക്യൂ, ബ്ലർ, നോയ്സ് തുടങ്ങിയ യഥാർത്ഥ ലോക ഡീഗ്രേഡേഷനിൽ കണ്ടെത്തലിനും തിരിച്ചറിയലിനും വേണ്ടി ഏകദേശം 100,000 വികലമായ ഡോക്യുമെന്റ് ഇമേജുകൾ.
ഏറ്റവും മികച്ച സീൻ ടെക്സ്റ്റ് OCR ഡാറ്റാസെറ്റുകൾ ഏതൊക്കെയാണ്?
അടയാളങ്ങൾ, ഉൽപ്പന്നങ്ങൾ, തെരുവ് ദൃശ്യങ്ങൾ തുടങ്ങിയ സ്വാഭാവിക ചിത്രങ്ങളിലെ വാചകം വായിക്കാൻ സീൻ-ടെക്സ്റ്റ് OCR ഡാറ്റാസെറ്റുകൾ മോഡലുകളെ പരിശീലിപ്പിക്കുന്നു. പശ്ചാത്തലങ്ങൾ അലങ്കോലപ്പെട്ടിരിക്കുന്ന ഇൻ-ദി-വൈൽഡ് OCR-ന് ഇവ അത്യാവശ്യമാണ്.
- ഐസിഡിഎആർ റോബസ്റ്റ് റീഡിംഗ് — ഫോക്കസ്ഡ്, ഇൻസിഡന്റൽ സീൻ ടെക്സ്റ്റ് എന്നിവയുൾപ്പെടെ മിക്ക സീൻ-ടെക്സ്റ്റ് ഗവേഷണങ്ങൾക്കും പിന്നിലുള്ള ബെഞ്ച്മാർക്ക് കുടുംബം, വേഡ്-ലെവൽ ബൗണ്ടിംഗ് ബോക്സുകളും ട്രാൻസ്ക്രിപ്ഷനുകളുമായുള്ള വെല്ലുവിളികളാണ്.
- കൊക്കോ-ടെക്സ്റ്റ് — MS-COCO ചിത്രങ്ങളിൽ വലിയ തോതിലുള്ള ദൃശ്യ-വാചക വ്യാഖ്യാനങ്ങൾ പാളികളായി നൽകിയിരിക്കുന്നു. സ്വാഭാവിക ദൃശ്യങ്ങളിൽ സ്കെയിലിൽ വാചകം കണ്ടെത്തുന്നതിന് ശക്തമാണ്.
- ആകെ-ടെക്സ്റ്റ് — വളഞ്ഞതും ക്രമരഹിതമായി ഓറിയന്റഡ് ചെയ്തതുമായ വാചകത്തിൽ വൈദഗ്ദ്ധ്യം നേടിയിട്ടുണ്ട്, പഴയ OCR മോഡലുകൾക്ക് ഇത് ഒരു ദുർബലമായ സ്ഥലമാണെന്ന് അറിയപ്പെടുന്നു.
- എസ്വിടി (തെരുവ് കാഴ്ചാ വാചകം) — ഗൂഗിൾ സ്ട്രീറ്റ് വ്യൂവിൽ നിന്ന് ശേഖരിച്ച വേഡ് ഇമേജുകൾ, പലപ്പോഴും കുറഞ്ഞ റെസല്യൂഷനും ഉയർന്ന വേരിയബിളിറ്റിയും. കോഡ് മിററുകളുള്ള പേപ്പറുകൾ വഴി ലഭ്യമാണ്.
- ഹൈയർടെക്സ്റ്റ് — ഖണ്ഡികയിൽ നിന്ന് വരിയിലേക്ക്, കൈയെഴുത്തും അച്ചടിച്ചതുമായ രംഗ വാചകം ഉൾക്കൊള്ളുന്ന ശ്രേണിപരമായ വ്യാഖ്യാനം. ലേഔട്ട് അവബോധമുള്ള OCR-ന് ഉപയോഗപ്രദമാണ്.
ഏറ്റവും മികച്ച അക്ക, പ്രതീക OCR ഡാറ്റാസെറ്റുകൾ ഏതൊക്കെയാണ്?
നിയന്ത്രിത ക്രമീകരണങ്ങളിൽ വ്യക്തിഗത ചിഹ്നങ്ങൾ തിരിച്ചറിയാൻ മോഡലുകളെ പരിശീലിപ്പിക്കുന്ന അക്ക, പ്രതീക OCR ഡാറ്റാസെറ്റുകൾ. വർഗ്ഗീകരണ അടിസ്ഥാനരേഖകൾക്കുള്ള സ്റ്റാൻഡേർഡ് ആരംഭ പോയിന്റുകളാണിവ.
- MNIST — 70,000 ഗ്രേസ്കെയിൽ കൈകൊണ്ട് എഴുതിയ അക്ക ചിത്രങ്ങൾ. ഒരു അക്ക ക്ലാസിഫയർ സാധൂകരിക്കുന്നതിനുള്ള ഏറ്റവും വേഗതയേറിയ അടിസ്ഥാനരേഖ.
- എമ്നിസ്റ്റ് — NIST സ്പെഷ്യൽ ഡാറ്റാബേസ് 19 ൽ നിന്ന് ഉരുത്തിരിഞ്ഞ 814,255 കൈയെഴുത്ത് അക്ഷരങ്ങളും അക്കങ്ങളും ഉപയോഗിച്ച് MNIST വിപുലീകരിക്കുന്നു.
- SVHN (സ്ട്രീറ്റ് വ്യൂ ഹൗസ് നമ്പറുകൾ) — വീട്ടു നമ്പറുകളിൽ നിന്ന് 600,000-ത്തിലധികം യഥാർത്ഥ അക്ക ചിത്രങ്ങൾ. ശബ്ദായമാനമായ സാഹചര്യങ്ങളിൽ MNIST-ൽ നിന്നുള്ള ഒരു പ്രായോഗിക പടി.
- ചാർസ്74കെ — സ്വാഭാവിക ചിത്രങ്ങളിൽ നിന്നും കമ്പ്യൂട്ടർ ഫോണ്ടുകളിൽ നിന്നുമുള്ള ഇംഗ്ലീഷ്, കന്നഡ അക്ഷരങ്ങൾ ഉൾക്കൊള്ളുന്ന 74,107 ചിത്രങ്ങൾ.
- എൻഐഎസ്ടി സ്പെഷ്യൽ ഡാറ്റാബേസ് 19 — 3,600 എഴുത്തുകാരിൽ നിന്ന് 810,000+ കൈകൊണ്ട് അച്ചടിച്ച കഥാപാത്ര ചിത്രങ്ങൾ. പല ഇംഗ്ലീഷ് OCR ബെഞ്ച്മാർക്കുകളും ഉത്ഭവിച്ച ഉറവിടം.
OCR-ന് ഏറ്റവും മികച്ച കൈയക്ഷര ഡാറ്റാസെറ്റുകൾ ഏതൊക്കെയാണ്?
കഴ്സീവ്, പ്രിന്റ് ചെയ്ത, ചരിത്രപരമായ കൈയ്യക്ഷര വാചകം വായിക്കാൻ OCR മോഡലുകളെ ഹാൻഡ്റൈറ്റിംഗ് ഡാറ്റാസെറ്റുകൾ പരിശീലിപ്പിക്കുന്നു. ഏറ്റവും ശക്തമായ ഓപ്പൺ ഹാൻഡ്റൈറ്റിംഗ് ഡാറ്റാസെറ്റുകൾ ഹാൻഡ്റൈറ്റിംഗ് ടെക്സ്റ്റ് റെക്കഗ്നിഷനുള്ള (HTR) ഏറ്റവും കൂടുതൽ ഉദ്ധരിക്കപ്പെടുന്ന ബെഞ്ച്മാർക്കുകളായി തുടരുന്നു.
- IAM കൈയക്ഷര ഡാറ്റാബേസ് — 657 എഴുത്തുകാരിൽ നിന്നുള്ള 13,353 ടെക്സ്റ്റ് ലൈനുകളുള്ള ഇംഗ്ലീഷ് കൈയക്ഷര സ്വർണ്ണ നിലവാരം. 2024–2025 OCR ഗവേഷണത്തിൽ ഇപ്പോഴും ഏറ്റവും കൂടുതൽ ഉദ്ധരിക്കപ്പെടുന്ന കൈയക്ഷര ഡാറ്റാസെറ്റ്.
- IAM-OnDB — IAM-ന്റെ ഓൺലൈൻ പെൻ-സ്ട്രോക്ക് പതിപ്പ്, ട്രാജക്ടറി ഡാറ്റ പിടിച്ചെടുക്കുന്നു. സ്റ്റൈലസ്, ടാബ്ലെറ്റ് തിരിച്ചറിയലിനുള്ള കാനോനിക്കൽ കൈയക്ഷര ഡാറ്റാസെറ്റ്.
- ബെന്താം പേപ്പേഴ്സ് — തത്ത്വചിന്തകനായ ജെറമി ബെന്താമിൽ നിന്ന് പകർത്തിയെഴുതിയ ചരിത്ര ഇംഗ്ലീഷ് കൈയെഴുത്തുപ്രതികൾ. ചരിത്രപരമായ കൈയക്ഷര OCR-നുള്ള മുൻനിര മാനദണ്ഡം, ട്രാൻസ്ക്രിബസ് വഴി ആക്സസ് ചെയ്യാവുന്നതാണ്.
- ജിഎൻഎച്ച്കെ (ഗുഡ്നോട്ട്സ് കൈയക്ഷര ശേഖരം) — നിയന്ത്രണങ്ങളില്ലാത്ത യഥാർത്ഥ ലോക ഇംഗ്ലീഷ് കൈയെഴുത്ത് കുറിപ്പുകളുടെ 2021 ഡാറ്റാസെറ്റ്. ലാബ്-ക്ലീൻ IAM-നേക്കാൾ കുഴപ്പമുള്ള പ്രൊഡക്ഷൻ ഡാറ്റയോട് അടുത്താണ്.
മികച്ച ബഹുഭാഷാ, ലാറ്റിൻ ഇതര OCR ഡാറ്റാസെറ്റുകൾ ഏതൊക്കെയാണ്?
ബഹുഭാഷാ OCR ഡാറ്റാസെറ്റുകൾ ചൈനീസ്, അറബിക്, ഗണിതശാസ്ത്ര നൊട്ടേഷൻ എന്നിവയുൾപ്പെടെ ഇംഗ്ലീഷിന് പുറത്തുള്ള സ്ക്രിപ്റ്റുകളിൽ മോഡലുകളെ പരിശീലിപ്പിക്കുന്നു. ആഗോള പ്രമാണ, കൈയക്ഷര തിരിച്ചറിയലിന് ഇവ അത്യാവശ്യമാണ്.
- കാസിയ-എച്ച്ഡബ്ല്യുഡിബി — 1,020 എഴുത്തുകാരിൽ നിന്ന് 1.17 ദശലക്ഷം കൈയ്യക്ഷര പ്രതീക സാമ്പിളുകൾ ഉൾക്കൊള്ളുന്ന സ്റ്റാൻഡേർഡ് ചൈനീസ് OCR ബെഞ്ച്മാർക്ക്.
- ഖട്ട് — 1,000 വ്യത്യസ്ത എഴുത്തുകാരിൽ നിന്നുള്ള 1,000 അറബിക് കൈയെഴുത്ത് ഫോമുകൾ, ഒന്നിലധികം റെസല്യൂഷനുകളിൽ സ്കാൻ ചെയ്തു. ഏറ്റവും സമഗ്രമായ തുറന്ന അറബിക് OCR ഡാറ്റാസെറ്റ്.
- ക്രോം — ഓൺലൈൻ കൈയെഴുത്ത് ഗണിത പദപ്രയോഗങ്ങളുടെ തിരിച്ചറിയൽ മത്സരം: 101+ ഗണിത ചിഹ്നങ്ങളിലായി 10,000+ പദപ്രയോഗങ്ങൾ, ഓൺലൈനിലും ഓഫ്ലൈനിലും. കൈയെഴുത്ത് സമവാക്യ OCR-ന് അത്യാവശ്യമാണ്.
സൌജന്യ OCR ഡാറ്റാസെറ്റുകൾ ഉപയോഗിക്കുമ്പോൾ ഉണ്ടാകുന്ന പൊതുവായ പിഴവുകൾ എന്തൊക്കെയാണ്?
മിക്ക ടീമുകളെയും പിടികൂടുന്നത് മൂന്ന് കെണികളാണ്.
ഡൊമെയ്ൻ പൊരുത്തക്കേട്: ക്ലീൻ IAM അല്ലെങ്കിൽ COCO-ടെക്സ്റ്റിനെക്കുറിച്ചുള്ള പരിശീലനവും തകർന്ന ഇൻവോയ്സുകളിൽ വിന്യസിക്കലും മോശം കൃത്യത ഉറപ്പ് നൽകുന്നു.
ലൈസൻസ് ബ്ലൈൻഡ്നെസ്സ്: നിരവധി സീൻ-ടെക്സ്റ്റ്, ഹിസ്റ്റോറിക്കൽ OCR ഡാറ്റാസെറ്റുകൾ ഗവേഷണം മാത്രമുള്ളതാണ് അല്ലെങ്കിൽ വാണിജ്യ ഉപയോഗത്തിന് മുമ്പ് രജിസ്ട്രേഷൻ ആവശ്യമാണ്.
വ്യാഖ്യാന വിടവുകൾ: പല OCR ഡാറ്റാസെറ്റുകളിലും പ്രൊഡക്ഷൻ സിസ്റ്റങ്ങൾക്ക് ആവശ്യമായ ലേഔട്ട് മെറ്റാഡാറ്റ, ലൈൻ-ലെവൽ ബൗണ്ടിംഗ് ബോക്സുകൾ അല്ലെങ്കിൽ ഫീൽഡ് ലേബലുകൾ ഇല്ല.
ഷിപ്പിംഗ്-ലേബൽ റീഡിംഗ് ഓട്ടോമേറ്റ് ചെയ്യുന്ന ഒരു ഇടത്തരം ലോജിസ്റ്റിക്സ് സ്ഥാപനത്തെ സങ്കൽപ്പിക്കുക. പൊതു രംഗ-വാചക പരിശീലനം അവരെ ബെഞ്ച്മാർക്കുകളിൽ 80% ആക്കുന്നു, എന്നാൽ ഗ്ലെയറും മടക്കുകളും ഉള്ള യഥാർത്ഥ ലേബലുകൾ അവരെ 58% ആയി കുറയ്ക്കുന്നു. ആ വിടവ് നികത്തുന്നതിന് സമാരംഭിക്കുന്നതിന് മുമ്പ് 6,000 ഇൻ-ഡൊമെയ്ൻ ലേബൽ ചിത്രങ്ങളുടെ ടാർഗെറ്റുചെയ്ത ഡാറ്റ അനോട്ടേഷൻ ആവശ്യമാണ്.
ഓപ്പൺ സോഴ്സ് ഡാറ്റാസെറ്റുകളുടെ പ്രയോജനങ്ങളും വെല്ലുവിളികളും
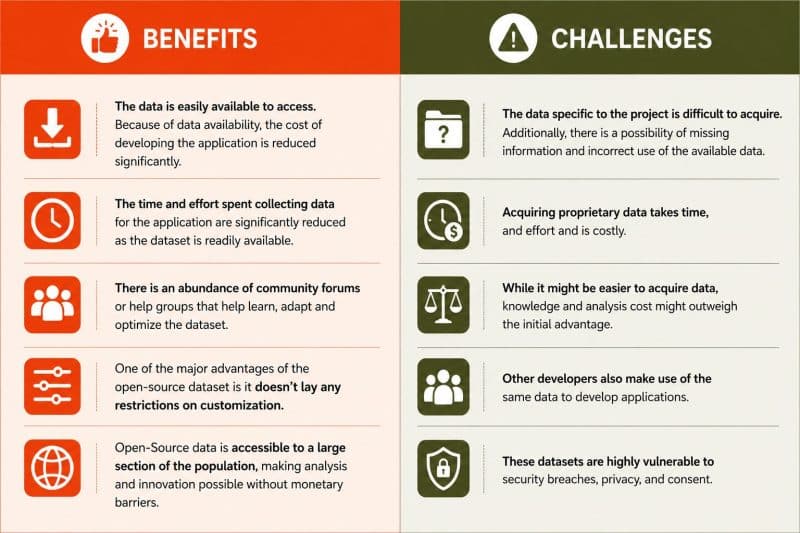
തങ്ങളുടെ ML ആപ്ലിക്കേഷനുകൾക്കായി സൗജന്യമായി ഉപയോഗിക്കാവുന്ന ഡാറ്റ തിരഞ്ഞെടുക്കേണ്ടതുണ്ടോ എന്ന് മനസ്സിലാക്കാൻ ബിസിനസുകൾ പരസ്പരം നേട്ടങ്ങളും വെല്ലുവിളികളും നേരിടേണ്ടതുണ്ട്.
ആനുകൂല്യങ്ങൾ
- ഡാറ്റ എളുപ്പത്തിൽ ആക്സസ് ചെയ്യാൻ ലഭ്യമാണ്. ഡാറ്റ ലഭ്യത കാരണം, ആപ്ലിക്കേഷൻ വികസിപ്പിക്കുന്നതിനുള്ള ചെലവ് ഗണ്യമായി കുറയുന്നു.
- ഡാറ്റാസെറ്റ് എളുപ്പത്തിൽ ലഭ്യമായതിനാൽ ആപ്ലിക്കേഷനായി ഡാറ്റ ശേഖരിക്കുന്നതിന് ചെലവഴിക്കുന്ന സമയവും പരിശ്രമവും ഗണ്യമായി കുറയുന്നു.
- ഡാറ്റാസെറ്റ് പഠിക്കാനും പൊരുത്തപ്പെടുത്താനും ഒപ്റ്റിമൈസ് ചെയ്യാനും സഹായിക്കുന്ന ധാരാളം കമ്മ്യൂണിറ്റി ഫോറങ്ങളോ സഹായ ഗ്രൂപ്പുകളോ ഉണ്ട്.
- ഓപ്പൺ സോഴ്സ് ഡാറ്റാസെറ്റിന്റെ ഒരു പ്രധാന നേട്ടം അത് കസ്റ്റമൈസേഷനിൽ യാതൊരു നിയന്ത്രണവും ഏർപ്പെടുത്തുന്നില്ല എന്നതാണ്.
- ഓപ്പൺ സോഴ്സ് ഡാറ്റ ജനസംഖ്യയുടെ വലിയൊരു വിഭാഗത്തിന് ആക്സസ് ചെയ്യാൻ കഴിയും, ഇത് പണ തടസ്സങ്ങളില്ലാതെ വിശകലനവും നവീകരണവും സാധ്യമാക്കുന്നു.
വെല്ലുവിളികൾ
- പ്രോജക്റ്റിന്റെ നിർദ്ദിഷ്ട ഡാറ്റ നേടുന്നത് ബുദ്ധിമുട്ടാണ്. കൂടാതെ, വിവരങ്ങൾ നഷ്ടപ്പെടാനും ലഭ്യമായ ഡാറ്റയുടെ തെറ്റായ ഉപയോഗത്തിനും സാധ്യതയുണ്ട്.
- പ്രൊപ്രൈറ്ററി ഡാറ്റ നേടുന്നതിന് സമയവും പരിശ്രമവും ആവശ്യമാണ്, ചെലവേറിയതുമാണ്
- ഡാറ്റ നേടുന്നത് എളുപ്പമായിരിക്കുമെങ്കിലും, അറിവും വിശകലന ചെലവും പ്രാരംഭ നേട്ടത്തേക്കാൾ കൂടുതലായിരിക്കാം.
- ആപ്ലിക്കേഷനുകൾ വികസിപ്പിക്കുന്നതിന് മറ്റ് ഡെവലപ്പർമാരും ഇതേ ഡാറ്റ ഉപയോഗിക്കുന്നു.
- ഈ ഡാറ്റാസെറ്റുകൾ സുരക്ഷാ ലംഘനങ്ങൾ, സ്വകാര്യത, സമ്മതം എന്നിവയ്ക്ക് വളരെ ദുർബലമാണ്.
OCR, കൈയക്ഷര തിരിച്ചറിയൽ പ്രോജക്ടുകളെ Shaip എങ്ങനെയാണ് പിന്തുണയ്ക്കുന്നത്?
Shaip-ന്റെ OCR പരിശീലന ഡാറ്റ സേവനങ്ങൾ 60+ ഭാഷകളിലായി ഓപ്പൺ-ഡാറ്റാസെറ്റ് ക്യൂറേഷനുമായി ഇഷ്ടാനുസൃത ഡാറ്റ ശേഖരണം ജോടിയാക്കുന്നു , അച്ചടിച്ച പ്രമാണങ്ങൾ, കൈയക്ഷരം, രസീതുകൾ, ഐഡികൾ എന്നിവ ഇതിൽ ഉൾപ്പെടുന്നു. Shaip-ന്റെ അനോട്ടേഷൻ വർക്ക്ഫ്ലോകൾ പൊതു OCR ഡാറ്റാസെറ്റുകൾ നഷ്ടപ്പെടുത്തുന്ന ലെയറുകൾ ചേർക്കുന്നു: ലൈൻ-ലെവൽ ബൗണ്ടിംഗ് ബോക്സുകൾ, ഫീൽഡ്-ലെവൽ ലേബലുകൾ, ട്രാൻസ്ക്രിപ്ഷൻ QC, റൈറ്റർ മെറ്റാഡാറ്റ.
തീരുമാനം
മുകളിലുള്ള 22 OCR ഡാറ്റാസെറ്റുകൾ 2026-ലേക്കുള്ള ഡോക്യുമെന്റ്, സീൻ ടെക്സ്റ്റ്, ഡിജിറ്റ്, ഹാൻഡ്റൈറ്റിംഗ്, ബഹുഭാഷാ തിരിച്ചറിയൽ എന്നിവയിലുടനീളം പൂർണ്ണമായ ഒരു ഓപ്പൺ സോഴ്സ് അടിത്തറ നിങ്ങൾക്ക് നൽകുന്നു. നിങ്ങളുടെ ടെക്സ്റ്റ് തരത്തിനും ക്യാപ്ചർ പരിതസ്ഥിതിക്കും അനുയോജ്യമായ OCR ഡാറ്റാസെറ്റിൽ നിന്ന് ആരംഭിക്കുക, നിങ്ങളുടെ യഥാർത്ഥ ഡാറ്റയുടെ ഒരു ഹോൾഡ്-ഔട്ട് സാമ്പിളിനെതിരെ സാധൂകരിക്കുക, ഡൊമെയ്ൻ വിടവ് നികത്തുന്നതിനുള്ള ഇഷ്ടാനുസൃത വ്യാഖ്യാനത്തിനുള്ള ബജറ്റ്. ആ കോമ്പിനേഷൻ ആദ്യം മുതൽ നിർമ്മിക്കുന്നതിനേക്കാൾ വേഗത്തിൽ ലഭിക്കും.