ലോകമെമ്പാടുമുള്ള നയരൂപീകരണക്കാർ, ബിസിനസുകൾ, ശാസ്ത്രം, മാധ്യമ സ്ഥാപനങ്ങൾ, വിവിധ വ്യവസായങ്ങൾ എന്നിവയെ AI, ബിഗ് ഡാറ്റ, മെഷീൻ ലേണിംഗ് എന്നിവ സ്വാധീനിക്കുന്നത് തുടരുന്നു. 2022 ൽ ആഗോളതലത്തിൽ AI സ്വീകരിക്കുന്ന നിരക്ക് നിലവിൽ 35% ആണെന്ന് റിപ്പോർട്ടുകൾ സൂചിപ്പിക്കുന്നു - 2021 നെ അപേക്ഷിച്ച് 4% വർദ്ധനവ്. 42% കമ്പനികൾ കൂടി തങ്ങളുടെ ബിസിനസിന് AI യുടെ നിരവധി നേട്ടങ്ങൾ പര്യവേക്ഷണം ചെയ്യുന്നുണ്ടെന്ന് റിപ്പോർട്ടുണ്ട്.
നിരവധി AI സംരംഭങ്ങളെയും മെഷീൻ ലേണിംഗ് പരിഹാരങ്ങളെയും ശക്തിപ്പെടുത്തുന്നത് ഡാറ്റയാണ്. അൽഗോരിതം നൽകുന്ന ഡാറ്റയോളം മാത്രമേ AI മികച്ചതാകൂ. കുറഞ്ഞ നിലവാരമുള്ള ഡാറ്റ ഗുണനിലവാരം കുറഞ്ഞ ഫലങ്ങളിലേക്കും കൃത്യമല്ലാത്ത പ്രവചനങ്ങളിലേക്കും നയിച്ചേക്കാം.
എംഎൽ, എഐ സൊല്യൂഷൻ വികസനത്തിൽ വളരെയധികം ശ്രദ്ധ ചെലുത്തിയിട്ടുണ്ടെങ്കിലും, ഒരു ഗുണനിലവാര ഡാറ്റാസെറ്റായി എന്താണ് യോഗ്യത നേടുന്നത് എന്നതിനെക്കുറിച്ചുള്ള അവബോധം നഷ്ടപ്പെട്ടിരിക്കുന്നു. ഈ ലേഖനത്തിൽ, ഗുണനിലവാരമുള്ള എഐ പരിശീലന ഡാറ്റയുടെ ടൈംലൈൻ ഞങ്ങൾ നാവിഗേറ്റ് ചെയ്യുകയും ഡാറ്റ ശേഖരണത്തെയും പരിശീലനത്തെയും കുറിച്ചുള്ള ഒരു ധാരണയിലൂടെ എഐയുടെ ഭാവി തിരിച്ചറിയുകയും ചെയ്യുന്നു.
AI പരിശീലന ഡാറ്റയുടെ നിർവ്വചനം
ഒരു ML പരിഹാരം നിർമ്മിക്കുമ്പോൾ, പരിശീലന ഡാറ്റാസെറ്റിന്റെ അളവും ഗുണനിലവാരവും പ്രധാനമാണ്. ML സിസ്റ്റത്തിന് ചലനാത്മകവും നിഷ്പക്ഷവും മൂല്യവത്തായതുമായ പരിശീലന ഡാറ്റയുടെ വലിയ അളവുകൾ ആവശ്യമാണെന്ന് മാത്രമല്ല, അതിന് ധാരാളം ആവശ്യമുണ്ട്.
എന്നാൽ AI പരിശീലന ഡാറ്റ എന്താണ്?
കൃത്യമായ പ്രവചനങ്ങൾ നടത്താൻ ML അൽഗോരിതം പരിശീലിപ്പിക്കാൻ ഉപയോഗിക്കുന്ന ലേബൽ ചെയ്ത ഡാറ്റയുടെ ഒരു ശേഖരമാണ് AI പരിശീലന ഡാറ്റ. പാറ്റേണുകൾ തിരിച്ചറിയാനും തിരിച്ചറിയാനും പാരാമീറ്ററുകൾ തമ്മിലുള്ള ബന്ധങ്ങൾ മനസ്സിലാക്കാനും ആവശ്യമായ തീരുമാനങ്ങൾ എടുക്കാനും പരിശീലന ഡാറ്റയെ അടിസ്ഥാനമാക്കി വിലയിരുത്താനും ML സിസ്റ്റം ശ്രമിക്കുന്നു.
ഉദാഹരണത്തിന് സെൽഫ് ഡ്രൈവിംഗ് കാറുകളുടെ ഉദാഹരണം എടുക്കുക. ഒരു സ്വയം-ഡ്രൈവിംഗ് ML മോഡലിനുള്ള പരിശീലന ഡാറ്റാസെറ്റിൽ കാറുകൾ, കാൽനടയാത്രക്കാർ, തെരുവ് അടയാളങ്ങൾ, മറ്റ് വാഹനങ്ങൾ എന്നിവയുടെ ലേബൽ ചെയ്ത ചിത്രങ്ങളും വീഡിയോകളും ഉൾപ്പെടുത്തണം.
ചുരുക്കത്തിൽ, ML അൽഗോരിതത്തിന്റെ ഗുണനിലവാരം വർദ്ധിപ്പിക്കുന്നതിന്, നിങ്ങൾക്ക് നന്നായി ചിട്ടപ്പെടുത്തിയതും വ്യാഖ്യാനിച്ചതും ലേബൽ ചെയ്തതുമായ പരിശീലന ഡാറ്റയുടെ വലിയ അളവുകൾ ആവശ്യമാണ്.
ഗുണനിലവാരമുള്ള പരിശീലന ഡാറ്റയുടെ പ്രാധാന്യവും അതിന്റെ പരിണാമവും
AI, ML ആപ്പ് വികസനത്തിലെ പ്രധാന ഇൻപുട്ടാണ് ഉയർന്ന നിലവാരമുള്ള പരിശീലന ഡാറ്റ. വിവിധ സ്രോതസ്സുകളിൽ നിന്ന് ഡാറ്റ ശേഖരിക്കുകയും മെഷീൻ ലേണിംഗ് ആവശ്യങ്ങൾക്ക് അനുയോജ്യമല്ലാത്ത ഒരു അസംഘടിത രൂപത്തിൽ അവതരിപ്പിക്കുകയും ചെയ്യുന്നു. ഗുണമേന്മയുള്ള പരിശീലന ഡാറ്റ - ലേബൽ ചെയ്തതും വ്യാഖ്യാനിച്ചതും ടാഗ് ചെയ്തതും - എല്ലായ്പ്പോഴും ഒരു സംഘടിത ഫോർമാറ്റിലാണ് - ML പരിശീലനത്തിന് അനുയോജ്യമാണ്.
ഗുണമേന്മയുള്ള പരിശീലന ഡാറ്റ ML സിസ്റ്റത്തിന് ഒബ്ജക്റ്റുകൾ തിരിച്ചറിയാനും മുൻകൂട്ടി നിശ്ചയിച്ച സവിശേഷതകൾക്കനുസരിച്ച് അവയെ തരംതിരിക്കാനും എളുപ്പമാക്കുന്നു. വർഗ്ഗീകരണം കൃത്യമല്ലെങ്കിൽ ഡാറ്റാസെറ്റ് മോശം മോഡൽ ഫലങ്ങൾ നൽകിയേക്കാം.
AI പരിശീലന ഡാറ്റയുടെ ആദ്യ ദിനങ്ങൾ
ഇന്നത്തെ ബിസിനസ്, ഗവേഷണ ലോകത്ത് AI ആധിപത്യം പുലർത്തുന്നുണ്ടെങ്കിലും, ML ആർട്ടിഫിഷ്യൽ ഇന്റലിജൻസ് ആധിപത്യം സ്ഥാപിക്കുന്നതിനു മുമ്പുള്ള ആദ്യ നാളുകൾ തികച്ചും വ്യത്യസ്തമായിരുന്നു.
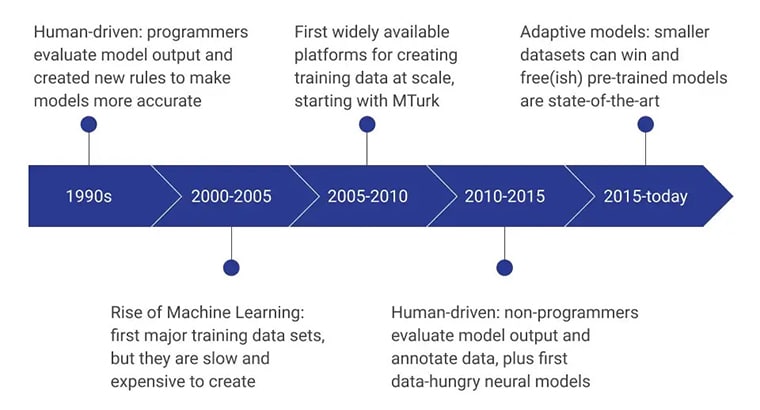
അടുത്ത കുറച്ച് വർഷങ്ങൾ, പ്രോഗ്രാമർമാർ അല്ലാത്തവർ ഡാറ്റ മോഡലുകൾ സൃഷ്ടിക്കുന്നതിലും വിലയിരുത്തുന്നതിലും ശ്രദ്ധ കേന്ദ്രീകരിച്ചു. നിലവിൽ, നൂതന പരിശീലന ഡാറ്റ ശേഖരണ രീതികൾ ഉപയോഗിച്ച് വികസിപ്പിച്ച പ്രീ-പരിശീലനം ലഭിച്ച മോഡലുകളിലാണ് ശ്രദ്ധ കേന്ദ്രീകരിക്കുന്നത്.
ഗുണനിലവാരത്തേക്കാൾ അളവ്
പണ്ട് കാലത്ത് AI പരിശീലന ഡാറ്റാസെറ്റുകളുടെ സമഗ്രത വിലയിരുത്തുമ്പോൾ, ഡാറ്റാ ശാസ്ത്രജ്ഞർ ഗുണനിലവാരത്തേക്കാൾ AI പരിശീലന ഡാറ്റയുടെ അളവിലാണ് ശ്രദ്ധ കേന്ദ്രീകരിച്ചിരുന്നത്.
ഉദാഹരണത്തിന്, വലിയ ഡാറ്റാബേസുകൾ കൃത്യമായ ഫലങ്ങൾ നൽകുന്നു എന്ന ഒരു പൊതു തെറ്റിദ്ധാരണ ഉണ്ടായിരുന്നു. ഡാറ്റയുടെ വലിയ അളവ് ഡാറ്റയുടെ മൂല്യത്തിന്റെ നല്ല സൂചകമാണെന്ന് വിശ്വസിക്കപ്പെട്ടു. ഡാറ്റാസെറ്റിന്റെ മൂല്യം നിർണ്ണയിക്കുന്ന പ്രാഥമിക ഘടകങ്ങളിലൊന്ന് മാത്രമാണ് അളവ് - ഡാറ്റ ഗുണനിലവാരത്തിന്റെ പങ്ക് തിരിച്ചറിഞ്ഞു.
ഡാറ്റയുടെ ഗുണനിലവാരം ഡാറ്റയുടെ പൂർണ്ണത, വിശ്വാസ്യത, സാധുത, ലഭ്യത, സമയബന്ധിതത്വം എന്നിവയെ ആശ്രയിച്ചിരിക്കുന്നു എന്ന അവബോധം വർദ്ധിച്ചു. ഏറ്റവും പ്രധാനമായി, പ്രോജക്റ്റിനായുള്ള ഡാറ്റ അനുയോജ്യതയാണ് ശേഖരിക്കുന്ന ഡാറ്റയുടെ ഗുണനിലവാരം നിർണ്ണയിക്കുന്നത്.
മോശം പരിശീലന ഡാറ്റ കാരണം ആദ്യകാല AI സിസ്റ്റങ്ങളുടെ പരിമിതികൾ
നൂതന കമ്പ്യൂട്ടിംഗ് സിസ്റ്റങ്ങളുടെ അഭാവത്തോടൊപ്പം മോശം പരിശീലന ഡാറ്റയും ആദ്യകാല AI സിസ്റ്റങ്ങളുടെ പൂർത്തീകരിക്കപ്പെടാത്ത നിരവധി വാഗ്ദാനങ്ങളുടെ ഒരു കാരണമായിരുന്നു.
ഗുണനിലവാരമുള്ള പരിശീലന ഡാറ്റയുടെ അഭാവം കാരണം, ന്യൂറൽ ഗവേഷണത്തിന്റെ വികസനം തടസ്സപ്പെടുത്തുന്ന വിഷ്വൽ പാറ്റേണുകൾ കൃത്യമായി തിരിച്ചറിയാൻ ML പരിഹാരങ്ങൾക്ക് കഴിഞ്ഞില്ല. പല ഗവേഷകരും സംസാര ഭാഷ തിരിച്ചറിയുന്നതിനുള്ള വാഗ്ദാനങ്ങൾ തിരിച്ചറിഞ്ഞെങ്കിലും, സംഭാഷണ ഡാറ്റാസെറ്റുകളുടെ അഭാവം മൂലം സംഭാഷണ തിരിച്ചറിയൽ ഉപകരണങ്ങളുടെ ഗവേഷണത്തിനോ വികസനത്തിനോ ഫലപ്രാപ്തിയിലെത്താൻ കഴിഞ്ഞില്ല. ഉയർന്ന നിലവാരമുള്ള AI ഉപകരണങ്ങൾ വികസിപ്പിക്കുന്നതിനുള്ള മറ്റൊരു പ്രധാന തടസ്സം കമ്പ്യൂട്ടറുകളുടെ കമ്പ്യൂട്ടേഷണൽ, സ്റ്റോറേജ് കഴിവുകളുടെ അഭാവം ആയിരുന്നു.
ഗുണനിലവാരമുള്ള പരിശീലന ഡാറ്റയിലേക്കുള്ള മാറ്റം
ഡാറ്റാസെറ്റിന്റെ ഗുണനിലവാരം പ്രധാനമാണെന്ന അവബോധത്തിൽ പ്രകടമായ മാറ്റമുണ്ടായി. ML സിസ്റ്റത്തിന് മനുഷ്യ ബുദ്ധിയും തീരുമാനങ്ങൾ എടുക്കാനുള്ള കഴിവും കൃത്യമായി അനുകരിക്കുന്നതിന്, അത് ഉയർന്ന അളവിലുള്ള, ഉയർന്ന നിലവാരമുള്ള പരിശീലന ഡാറ്റയിൽ അഭിവൃദ്ധിപ്പെടേണ്ടതുണ്ട്.
നിങ്ങളുടെ ML ഡാറ്റയെ ഒരു സർവേ ആയി കരുതുക - ഡാറ്റ സാമ്പിൾ വലുപ്പം കൂടുന്തോറും പ്രവചനം മികച്ചതായിരിക്കും. സാമ്പിൾ ഡാറ്റയിൽ എല്ലാ വേരിയബിളുകളും ഉൾപ്പെടുന്നില്ലെങ്കിൽ, അത് പാറ്റേണുകൾ തിരിച്ചറിയുകയോ തെറ്റായ നിഗമനങ്ങളിൽ എത്തിച്ചേരുകയോ ചെയ്തേക്കില്ല.
AI സാങ്കേതികവിദ്യയിലെ പുരോഗതിയും മികച്ച പരിശീലന ഡാറ്റയുടെ ആവശ്യകതയും

മികച്ച പരിശീലന ഡാറ്റ വിശ്വസനീയമായ ML മോഡലുകളുടെ സാധ്യത വർദ്ധിപ്പിക്കുന്നു എന്ന ധാരണ മികച്ച ഡാറ്റാ ശേഖരണം, വ്യാഖ്യാനം, ലേബലിംഗ് രീതികൾ എന്നിവയ്ക്ക് കാരണമായി. ഡാറ്റയുടെ ഗുണനിലവാരവും പ്രസക്തിയും AI മോഡലിന്റെ ഗുണനിലവാരത്തെ നേരിട്ട് സ്വാധീനിച്ചു.

ഡാറ്റയുടെ ഗുണനിലവാരത്തിലും കൃത്യതയിലും ശ്രദ്ധ കേന്ദ്രീകരിക്കുന്നു
ML മോഡലിന് കൃത്യമായ ഫലങ്ങൾ നൽകുന്നതിന്, അത് ആവർത്തിച്ചുള്ള ഡാറ്റ റിഫൈനിംഗ് ഘട്ടങ്ങളിലൂടെ കടന്നുപോകുന്ന ഗുണമേന്മയുള്ള ഡാറ്റാസെറ്റുകളാണ് നൽകുന്നത്.
ഉദാഹരണത്തിന്, ഒരു മനുഷ്യന് നായയെ പരിചയപ്പെടുത്തി ഏതാനും ദിവസങ്ങൾക്കുള്ളിൽ ഒരു പ്രത്യേക ഇനം നായയെ തിരിച്ചറിയാൻ കഴിഞ്ഞേക്കും - ചിത്രങ്ങളിലൂടെയോ വീഡിയോകളിലൂടെയോ നേരിട്ടോ. ആവശ്യമുള്ളപ്പോൾ ഈ അറിവ് ഓർത്തുവയ്ക്കാനും ശേഖരിക്കാനും മനുഷ്യർ അവരുടെ അനുഭവത്തിൽ നിന്നും ബന്ധപ്പെട്ട വിവരങ്ങളിൽ നിന്നും എടുക്കുന്നു. എന്നിരുന്നാലും, ഒരു മെഷീനിൽ ഇത് എളുപ്പത്തിൽ പ്രവർത്തിക്കില്ല. കണക്ഷൻ ഉണ്ടാക്കാൻ ആ പ്രത്യേക ഇനത്തിന്റെയും മറ്റ് ഇനങ്ങളുടെയും - നൂറുകണക്കിന് അല്ലെങ്കിൽ ആയിരക്കണക്കിന് - വ്യക്തമായി വ്യാഖ്യാനിച്ചതും ലേബൽ ചെയ്തതുമായ ചിത്രങ്ങൾ യന്ത്രത്തിന് നൽകണം.
പരിശീലനം ലഭിച്ച വിവരങ്ങളെ യഥാർത്ഥ ലോകത്ത് അവതരിപ്പിക്കുന്ന വിവരങ്ങളുമായി പരസ്പരബന്ധിതമാക്കിയാണ് ഒരു AI മോഡൽ ഫലം പ്രവചിക്കുന്നത് . പരിശീലന ഡാറ്റയിൽ പ്രസക്തമായ വിവരങ്ങൾ ഉൾപ്പെടുത്തിയിട്ടില്ലെങ്കിൽ അൽഗോരിതം ഉപയോഗശൂന്യമാകും.
വൈവിധ്യവും പ്രാതിനിധ്യവുമായ പരിശീലന ഡാറ്റയുടെ പ്രാധാന്യം
ഒരു ഡാറ്റാസെറ്റ് ഒരു പ്രത്യേക ജനസംഖ്യ, വംശം, ലിംഗഭേദം, തിരഞ്ഞെടുപ്പ്, ബൗദ്ധിക അഭിപ്രായങ്ങൾ എന്നിവയോട് പക്ഷപാതപരമാകാം, അത് കൃത്യമല്ലാത്ത മാതൃകയിലേക്ക് നയിച്ചേക്കാം.
സബ്ജക്റ്റ് പൂൾ, ക്യൂറേഷൻ, വ്യാഖ്യാനം, ലേബലിംഗ് എന്നിവ തിരഞ്ഞെടുക്കുന്നത് ഉൾപ്പെടെയുള്ള മുഴുവൻ ഡാറ്റാ ശേഖരണ പ്രക്രിയ ഫ്ലോയും വേണ്ടത്ര വൈവിധ്യവും സമതുലിതവും ജനസംഖ്യയുടെ പ്രതിനിധിയുമാണെന്ന് ഉറപ്പാക്കേണ്ടത് പ്രധാനമാണ്.

AI പരിശീലന ഡാറ്റയുടെ ഭാവി
AI മോഡലുകളുടെ ഭാവി വിജയം ML അൽഗോരിതങ്ങൾ പരിശീലിപ്പിക്കാൻ ഉപയോഗിക്കുന്ന പരിശീലന ഡാറ്റയുടെ ഗുണനിലവാരത്തിലും അളവിലും ആശ്രയിച്ചിരിക്കുന്നു. ഡാറ്റയുടെ ഗുണനിലവാരവും അളവും തമ്മിലുള്ള ഈ ബന്ധം ടാസ്ക്-നിർദ്ദിഷ്ടമാണെന്നും കൃത്യമായ ഉത്തരമില്ലെന്നും തിരിച്ചറിയുന്നത് വളരെ പ്രധാനമാണ്.
ആത്യന്തികമായി, ഒരു പരിശീലന ഡാറ്റാ സെറ്റിന്റെ പര്യാപ്തത നിർവചിക്കുന്നത് അത് നിർമ്മിച്ച ഉദ്ദേശ്യത്തിനായി വിശ്വസനീയമായി പ്രവർത്തിക്കാനുള്ള അതിന്റെ കഴിവാണ്.
വിവരശേഖരണത്തിലും വ്യാഖ്യാന സാങ്കേതികതയിലും പുരോഗതി
ഫെഡ് ഡാറ്റയോട് ML സെൻസിറ്റീവ് ആയതിനാൽ, ഡാറ്റാ ശേഖരണവും വ്യാഖ്യാന നയങ്ങളും കാര്യക്ഷമമാക്കേണ്ടത് അത്യന്താപേക്ഷിതമാണ്. ഡാറ്റാ ശേഖരണം, ക്യൂറേഷൻ, തെറ്റായി പ്രതിനിധീകരിക്കൽ, അപൂർണ്ണമായ അളവുകൾ, കൃത്യതയില്ലാത്ത ഉള്ളടക്കം, ഡാറ്റ ഡ്യൂപ്ലിക്കേഷൻ, തെറ്റായ അളവുകൾ എന്നിവയിലെ പിശകുകൾ അപര്യാപ്തമായ ഡാറ്റയുടെ ഗുണനിലവാരത്തിന് കാരണമാകുന്നു.
ഡാറ്റാ മൈനിംഗ്, വെബ് സ്ക്രാപ്പിംഗ്, ഡാറ്റ എക്സ്ട്രാക്ഷൻ എന്നിവയിലൂടെയുള്ള സ്വയമേവയുള്ള ഡാറ്റ ശേഖരണം വേഗത്തിലുള്ള ഡാറ്റ ഉൽപ്പാദനത്തിന് വഴിയൊരുക്കുന്നു. കൂടാതെ, മുൻകൂട്ടി പാക്കേജുചെയ്ത ഡാറ്റാസെറ്റുകൾ ഒരു ദ്രുത-പരിഹാര ഡാറ്റാ ശേഖരണ സാങ്കേതികതയായി പ്രവർത്തിക്കുന്നു.
ഡാറ്റ ശേഖരണത്തിന്റെ മറ്റൊരു വഴിത്തിരിവായ രീതിയാണ് ക്രൗഡ്സോഴ്സിംഗ്. ഡാറ്റയുടെ കൃത്യത ഉറപ്പുനൽകാൻ കഴിയില്ലെങ്കിലും, പൊതുജനങ്ങളുടെ പ്രതിച്ഛായ ശേഖരിക്കുന്നതിനുള്ള ഒരു മികച്ച ഉപകരണമാണിത്. അവസാനമായി, പ്രത്യേക ഡാറ്റ ശേഖരണ വിദഗ്ധരും പ്രത്യേക ആവശ്യങ്ങൾക്കായി ശേഖരിച്ച ഡാറ്റ നൽകുന്നു.
പരിശീലന ഡാറ്റയിൽ ധാർമ്മിക പരിഗണനകൾക്ക് ഊന്നൽ വർദ്ധിപ്പിച്ചു
മുഖചിത്രങ്ങൾ, വിരലടയാളങ്ങൾ, വോയ്സ് റെക്കോർഡിംഗുകൾ, മറ്റ് നിർണായക ബയോമെട്രിക് ഡാറ്റ എന്നിവയിൽ നിന്ന് എല്ലാം ഇപ്പോൾ ഡാറ്റയിൽ ഉൾപ്പെട്ടിരിക്കുന്നതിനാൽ, വിലകൂടിയ വ്യവഹാരങ്ങളും പ്രശസ്തിക്ക് ഹാനികരവും ഒഴിവാക്കുന്നതിന് നിയമപരവും ധാർമ്മികവുമായ രീതികൾ പാലിക്കുന്നത് ഉറപ്പാക്കേണ്ടത് വളരെ പ്രധാനമാണ്.
ഭാവിയിൽ ഇതിലും മികച്ച നിലവാരവും വൈവിധ്യപൂർണ്ണവുമായ പരിശീലന ഡാറ്റയ്ക്കുള്ള സാധ്യത
ഭാവിയിൽ ഉയർന്ന നിലവാരമുള്ളതും വൈവിധ്യപൂർണ്ണവുമായ പരിശീലന ഡാറ്റയ്ക്ക് വലിയ സാധ്യതകളുണ്ട് . ഡാറ്റ ഗുണനിലവാരത്തെക്കുറിച്ചുള്ള അവബോധത്തിനും AI പരിഹാരങ്ങളുടെ ഗുണനിലവാര ആവശ്യങ്ങൾ നിറവേറ്റുന്ന ഡാറ്റ ദാതാക്കളുടെ ലഭ്യതയ്ക്കും നന്ദി.
വൈവിധ്യമാർന്ന ഡാറ്റാസെറ്റുകൾ ധാർമ്മികമായും നിയമപരമായും ഉറവിടമാക്കുന്നതിന് തകർപ്പൻ സാങ്കേതികവിദ്യകൾ ഉപയോഗിക്കുന്നതിൽ നിലവിലെ ഡാറ്റാ ദാതാക്കൾ സമർത്ഥരാണ്. വ്യത്യസ്ത ML പ്രോജക്റ്റുകൾക്കായി ഇഷ്ടാനുസൃതമാക്കിയ ഡാറ്റ ലേബൽ ചെയ്യാനും വ്യാഖ്യാനിക്കാനും അവതരിപ്പിക്കാനും അവർക്ക് ഇൻ-ഹൗസ് ടീമുകളുണ്ട്.

തീരുമാനം
ഉയർന്ന നിലവാരമുള്ള AI മോഡലുകൾ വികസിപ്പിക്കുന്നതിന് ഡാറ്റയെയും ഗുണനിലവാരത്തെയും കുറിച്ച് സൂക്ഷ്മമായ ധാരണയുള്ള വിശ്വസനീയമായ വെണ്ടർമാരുമായി പങ്കാളിത്തം സ്ഥാപിക്കേണ്ടത് പ്രധാനമാണ് . നിങ്ങളുടെ AI പ്രോജക്റ്റ് ആവശ്യങ്ങളും ലക്ഷ്യങ്ങളും നിറവേറ്റുന്ന ഇഷ്ടാനുസൃത ഡാറ്റ പരിഹാരങ്ങൾ നൽകുന്നതിൽ വൈദഗ്ധ്യമുള്ള മുൻനിര അനോട്ടേഷൻ കമ്പനിയാണ് ഷൈപ്പ്. ഞങ്ങളുമായി പങ്കാളിത്തം സ്ഥാപിച്ച് ഞങ്ങൾ കൊണ്ടുവരുന്ന കഴിവുകൾ, പ്രതിബദ്ധത, സഹകരണം എന്നിവ പര്യവേക്ഷണം ചെയ്യുക.