ഒരു കോഡിൽ പ്രവർത്തിക്കുന്ന സോഫ്റ്റ്വെയർ വികസനം പോലെ, പ്രവർത്തിക്കുന്ന ആർട്ടിഫിഷ്യൽ ഇന്റലിജൻസ് , മെഷീൻ ലേണിംഗ് മോഡലുകൾ വികസിപ്പിക്കുന്നതിന് ഉയർന്ന നിലവാരമുള്ള ഡാറ്റ ആവശ്യമാണ്. ജോലികൾ ഏറ്റെടുക്കുന്നതിന് അൽഗോരിതം തുടർച്ചയായി പരിശീലിപ്പിക്കേണ്ടതിനാൽ, മോഡലുകൾക്ക് ഉൽപാദനത്തിന്റെ ഒന്നിലധികം ഘട്ടങ്ങളിൽ കൃത്യമായി ലേബൽ ചെയ്തതും വ്യാഖ്യാനിച്ചതുമായ ഡാറ്റ ആവശ്യമാണ്.
പക്ഷേ, ഗുണനിലവാരമുള്ള ഡാറ്റ കണ്ടെത്തുക പ്രയാസമാണ്. ചിലപ്പോൾ, ഡാറ്റാസെറ്റുകളിൽ പ്രോജക്റ്റ് ഫലത്തെ ബാധിച്ചേക്കാവുന്ന പിശകുകൾ നിറഞ്ഞിരിക്കാം. ഡാറ്റ വിലയിരുത്തുന്നതിനും വിശകലനം ചെയ്യുന്നതിനുപകരം അവ വൃത്തിയാക്കുന്നതിനും സ്ക്രബ് ചെയ്യുന്നതിനുമാണ് കൂടുതൽ സമയം ചെലവഴിക്കുന്നതെന്ന് ആദ്യം നിങ്ങളോട് പറയുന്നത് ഡാറ്റാ സയൻസ് വിദഗ്ധരായിരിക്കും.
എന്തുകൊണ്ടാണ് ഡാറ്റാസെറ്റിൽ പിശകുകൾ ആദ്യം ഉണ്ടാകുന്നത്?
കൃത്യമായ പരിശീലന ഡാറ്റാസെറ്റുകൾ ഉണ്ടായിരിക്കേണ്ടത് അത്യാവശ്യമായിരിക്കുന്നത് എന്തുകൊണ്ട്?
AI പരിശീലന ഡാറ്റ പിശകുകളുടെ തരങ്ങൾ എന്തൊക്കെയാണ് ? അവ എങ്ങനെ ഒഴിവാക്കാം?
ചില സ്ഥിതിവിവരക്കണക്കുകൾ ഉപയോഗിച്ച് നമുക്ക് ആരംഭിക്കാം.
എംഐടി കമ്പ്യൂട്ടർ സയൻസ് ആൻഡ് ആർട്ടിഫിഷ്യൽ ഇന്റലിജൻസ് ലാബിലെ ഒരു കൂട്ടം ഗവേഷകർ 100,000-ത്തിലധികം തവണ ഉദ്ധരിക്കപ്പെട്ട പത്ത് വലിയ ഡാറ്റാസെറ്റുകൾ സൂക്ഷ്മമായി പരിശോധിച്ചു. വിശകലനം ചെയ്ത എല്ലാ ഡാറ്റാസെറ്റുകളിലും ശരാശരി പിശക് നിരക്ക് ഏകദേശം 3.4% ആണെന്ന് ഗവേഷകർ കണ്ടെത്തി. ഇമേജുകളുടെ തെറ്റായ ലേബലിംഗ്, ഓഡിയോ, ടെക്സ്റ്റ് വികാരങ്ങൾ എന്നിവ പോലുള്ള വിവിധ തരത്തിലുള്ള പിശകുകൾ ഡാറ്റാസെറ്റുകൾക്ക് ഉണ്ടായതായും കണ്ടെത്തി .
എന്തുകൊണ്ടാണ് ഡാറ്റാസെറ്റിൽ പിശകുകൾ ആദ്യം ഉണ്ടാകുന്നത്?

ഉദാഹരണത്തിന്, നിങ്ങളുടെ എല്ലാ ലൊക്കേഷൻ ബിസിനസുകളെയും കുറിച്ചുള്ള പൂർണ്ണമായ വിശദാംശങ്ങൾ ശേഖരിക്കാൻ നിങ്ങളുടെ ഓഫീസ് അസിസ്റ്റന്റിനോട് ആവശ്യപ്പെടുകയും അവ ഒരു സ്പ്രെഡ്ഷീറ്റിൽ നേരിട്ട് നൽകുകയും ചെയ്യുക. ഒരു ഘട്ടത്തിൽ അല്ലെങ്കിൽ മറ്റൊന്നിൽ, ഒരു പിശക് സംഭവിക്കും. വിലാസം തെറ്റായി പോകാം, തനിപ്പകർപ്പ് സംഭവിക്കാം, അല്ലെങ്കിൽ ഡാറ്റ പൊരുത്തക്കേട് സംഭവിക്കാം.
ഉപകരണങ്ങളുടെ തകരാർ, സെൻസർ കേടുപാടുകൾ അല്ലെങ്കിൽ അറ്റകുറ്റപ്പണികൾ എന്നിവ കാരണം സെൻസറുകൾ ശേഖരിക്കുകയാണെങ്കിൽ ഡാറ്റയിലെ പിശകുകളും സംഭവിക്കാം.
കൃത്യമായ പരിശീലന ഡാറ്റാസെറ്റുകൾ ഉണ്ടായിരിക്കേണ്ടത് അത്യാവശ്യമായിരിക്കുന്നത് എന്തുകൊണ്ട്?
നിങ്ങൾ നൽകുന്ന ഡാറ്റയിൽ നിന്നാണ് എല്ലാ മെഷീൻ ലേണിംഗ് അൽഗോരിതങ്ങളും പഠിക്കുന്നത്. ലേബൽ ചെയ്തതും വ്യാഖ്യാനിച്ചതുമായ ഡാറ്റ മോഡലുകളെ ബന്ധങ്ങൾ കണ്ടെത്താനും, ആശയങ്ങൾ മനസ്സിലാക്കാനും, തീരുമാനങ്ങൾ എടുക്കാനും, അവയുടെ പ്രകടനം വിലയിരുത്താനും സഹായിക്കുന്നു. ബന്ധപ്പെട്ട ചെലവുകളെക്കുറിച്ചോ പരിശീലനത്തിന് ആവശ്യമായ സമയത്തെക്കുറിച്ചോ വിഷമിക്കാതെ പിശകുകളില്ലാത്ത ഡാറ്റാസെറ്റുകളിൽ നിങ്ങളുടെ മെഷീൻ ലേണിംഗ് മോഡലിനെ പരിശീലിപ്പിക്കേണ്ടത് അത്യാവശ്യമാണ്. ദീർഘകാലാടിസ്ഥാനത്തിൽ പോലെ, ഗുണനിലവാരമുള്ള ഡാറ്റ നേടുന്നതിനായി നിങ്ങൾ ചെലവഴിക്കുന്ന സമയം നിങ്ങളുടെ AI പ്രോജക്റ്റുകളുടെ ഫലം വർദ്ധിപ്പിക്കും.
കൃത്യമായ ഡാറ്റയിൽ നിങ്ങളുടെ മോഡലുകളെ പരിശീലിപ്പിക്കുന്നത് നിങ്ങളുടെ മോഡലുകൾക്ക് കൃത്യമായ പ്രവചനങ്ങൾ നടത്താനും മോഡൽ പ്രകടനം വർദ്ധിപ്പിക്കാനും സഹായിക്കും . ഉപയോഗിക്കുന്ന ഗുണനിലവാരം, അളവ്, അൽഗോരിതങ്ങൾ എന്നിവയാണ് നിങ്ങളുടെ AI പ്രോജക്റ്റിന്റെ വിജയം നിർണ്ണയിക്കുന്നത്.
AI പരിശീലന ഡാറ്റ പിശകുകളുടെ തരങ്ങൾ എന്തൊക്കെയാണ്?
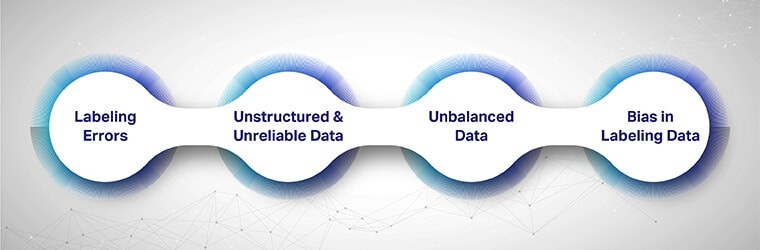
ലേബലിംഗ് പിശകുകൾ, വിശ്വസനീയമല്ലാത്ത ഡാറ്റ, അസന്തുലിതമായ ഡാറ്റ, ഡാറ്റ ബയസ്
ഏറ്റവും സാധാരണമായ നാല് പരിശീലന ഡാറ്റ പിശകുകളും അവ ഒഴിവാക്കാനുള്ള വഴികളും ഞങ്ങൾ നോക്കും.
ലേബലിംഗ് പിശകുകൾ
പരിശീലന ഡാറ്റയിൽ കാണപ്പെടുന്ന ഏറ്റവും സാധാരണമായ പിശകുകളിൽ ഒന്നാണ് ലേബലിംഗ് പിശകുകൾ . മോഡലിന്റെ ടെസ്റ്റ് ഡാറ്റയിൽ തെറ്റായി ലേബൽ ചെയ്ത ഡാറ്റാസെറ്റുകൾ ഉണ്ടെങ്കിൽ, തത്ഫലമായുണ്ടാകുന്ന പരിഹാരം സഹായകരമാകില്ല. മോഡലിന്റെ പ്രകടനത്തെക്കുറിച്ചോ ഗുണനിലവാരത്തെക്കുറിച്ചോ ഡാറ്റാ ശാസ്ത്രജ്ഞർക്ക് കൃത്യമോ അർത്ഥവത്തായതോ ആയ നിഗമനങ്ങളിൽ എത്തിച്ചേരാൻ കഴിയില്ല.
ലേബലിംഗ് പിശകുകൾ വിവിധ രൂപങ്ങളിൽ വരുന്നു. പോയിന്റ് വർദ്ധിപ്പിക്കുന്നതിന് ഞങ്ങൾ ഒരു ലളിതമായ ഉദാഹരണം ഉപയോഗിക്കുന്നു. ചിത്രങ്ങളിൽ ഓരോ പൂച്ചയ്ക്കും ചുറ്റും ബൗണ്ടിംഗ് ബോക്സുകൾ വരയ്ക്കുക എന്നത് ഡാറ്റാ വ്യാഖ്യാനകർക്ക് ലളിതമായ ഒരു ജോലിയാണെങ്കിൽ, ഇനിപ്പറയുന്ന തരത്തിലുള്ള ലേബലിംഗ് പിശകുകൾ സംഭവിക്കാം.
- കൃത്യതയില്ലാത്ത ഫിറ്റ്: മോഡൽ ഓവർഫിറ്റിംഗ് ബൗണ്ടിംഗ് ബോക്സുകൾ ഒബ്ജക്റ്റിനോട് (പൂച്ച) അടുത്ത് വരാത്തപ്പോൾ, ഉദ്ദേശിച്ച വസ്തുവിന് ചുറ്റും നിരവധി വിടവുകൾ ഉണ്ടാകുമ്പോൾ സംഭവിക്കുന്നു.
- നഷ്ടമായ ലേബലുകൾ: ഈ സാഹചര്യത്തിൽ, ചിത്രങ്ങളിൽ പൂച്ചയെ ലേബൽ ചെയ്യുന്നത് വ്യാഖ്യാനകന് നഷ്ടമായേക്കാം.
- നിർദ്ദേശത്തിന്റെ തെറ്റായ വ്യാഖ്യാനം: വ്യാഖ്യാനകർക്ക് നൽകിയ നിർദ്ദേശങ്ങൾ വ്യക്തമല്ല. ചിത്രങ്ങളിൽ ഓരോ പൂച്ചയ്ക്കും ചുറ്റും ഒരു ബൗണ്ടിംഗ് ബോക്സ് സ്ഥാപിക്കുന്നതിനുപകരം, വ്യാഖ്യാനകർ എല്ലാ പൂച്ചകളെയും ഉൾക്കൊള്ളുന്ന ഒരു ബൗണ്ടിംഗ് ബോക്സ് സ്ഥാപിക്കുന്നു.
- ഒക്ലൂഷൻ കൈകാര്യം ചെയ്യൽ: പൂച്ചയുടെ ദൃശ്യമായ ഭാഗത്തിന് ചുറ്റും ഒരു ബൗണ്ടിംഗ് ബോക്സ് സ്ഥാപിക്കുന്നതിനുപകരം, ഭാഗികമായി കാണാവുന്ന പൂച്ചയുടെ പ്രതീക്ഷിത രൂപത്തിന് ചുറ്റും വ്യാഖ്യാനകൻ ബൗണ്ടിംഗ് ബോക്സുകൾ സ്ഥാപിക്കുന്നു.
ഘടനയില്ലാത്തതും വിശ്വസനീയമല്ലാത്തതുമായ ഡാറ്റ
ഒരു ML പ്രോജക്റ്റിന്റെ വ്യാപ്തി അത് പരിശീലിപ്പിച്ച ഡാറ്റാസെറ്റിന്റെ തരത്തെ ആശ്രയിച്ചിരിക്കുന്നു. അപ്ഡേറ്റ് ചെയ്തതും വിശ്വസനീയവും ആവശ്യമായ ഫലത്തെ പ്രതിനിധീകരിക്കുന്നതുമായ ഡാറ്റാസെറ്റുകൾ സ്വന്തമാക്കാൻ ബിസിനസുകൾ അവരുടെ ഉറവിടങ്ങൾ ഉപയോഗിക്കണം.
അപ്ഡേറ്റ് ചെയ്യാത്ത ഡാറ്റയിൽ നിങ്ങൾ മോഡലിനെ പരിശീലിപ്പിക്കുമ്പോൾ, അത് ആപ്ലിക്കേഷനിൽ ദീർഘകാല പരിമിതികൾക്ക് കാരണമാകും. അസ്ഥിരവും ഉപയോഗശൂന്യവുമായ ഡാറ്റയിൽ നിങ്ങളുടെ മോഡലുകളെ പരിശീലിപ്പിക്കുകയാണെങ്കിൽ, അത് AI മോഡലിന്റെ പ്രയോജനത്തെ പ്രതിഫലിപ്പിക്കും.
അസന്തുലിതമായ ഡാറ്റ
ഏതെങ്കിലും ഡാറ്റ അസന്തുലിതാവസ്ഥ നിങ്ങളുടെ മോഡലിന്റെ പ്രകടനത്തിൽ പക്ഷപാതത്തിന് കാരണമായേക്കാം. ഉയർന്ന പ്രകടനമോ സങ്കീർണ്ണമോ ആയ മോഡലുകൾ നിർമ്മിക്കുമ്പോൾ, പരിശീലന ഡാറ്റ കോമ്പോസിഷൻ ശ്രദ്ധാപൂർവ്വം പരിഗണിക്കണം. ഡാറ്റ അസന്തുലിതാവസ്ഥ രണ്ട് തരത്തിലാകാം:
- ക്ലാസ് അസന്തുലിതാവസ്ഥ: ക്ലാസ് അസന്തുലിതാവസ്ഥ ഉണ്ടാകുമ്പോൾ പരിശീലന ഡാറ്റ ഉയർന്ന അസന്തുലിതമായ ക്ലാസ് വിതരണങ്ങൾ ഉണ്ട്. മറ്റൊരു വിധത്തിൽ പറഞ്ഞാൽ, പ്രതിനിധി ഡാറ്റാസെറ്റ് ഇല്ല. ഡാറ്റാസെറ്റുകളിൽ ക്ലാസ് അസന്തുലിതാവസ്ഥ ഉണ്ടാകുമ്പോൾ, യഥാർത്ഥ-ലോക ആപ്ലിക്കേഷനുകൾ ഉപയോഗിച്ച് നിർമ്മിക്കുമ്പോൾ അത് നിരവധി പ്രശ്നങ്ങൾ ഉണ്ടാക്കാം.
ഉദാഹരണത്തിന്, പൂച്ചകളെ തിരിച്ചറിയാൻ അൽഗോരിതം പരിശീലിപ്പിക്കുകയാണെങ്കിൽ, പരിശീലന ഡാറ്റയിൽ ചുവരുകളിൽ പൂച്ചകളുടെ ചിത്രങ്ങൾ മാത്രമേ ഉള്ളൂ. ചുവരുകളിൽ പൂച്ചകളെ തിരിച്ചറിയുമ്പോൾ മോഡൽ നന്നായി പ്രവർത്തിക്കും, പക്ഷേ വ്യത്യസ്ത സാഹചര്യങ്ങളിൽ മോശമായി പ്രവർത്തിക്കും. - ഡാറ്റ റീസെൻസി: ഒരു മോഡലും പൂർണ്ണമായും കാലികമല്ല. എല്ലാ മോഡലുകളും ഒരു അപചയത്തിന് വിധേയമാകുന്നു യഥാർത്ഥ ലോകം പരിസ്ഥിതി നിരന്തരം രൂപാന്തരപ്പെടുന്നു. ഈ പാരിസ്ഥിതിക മാറ്റങ്ങളെക്കുറിച്ച് മോഡൽ പതിവായി അപ്ഡേറ്റ് ചെയ്യുന്നില്ലെങ്കിൽ, അതിന്റെ ഉപയോഗവും മൂല്യവും കുറയാൻ സാധ്യതയുണ്ട്.
ഉദാഹരണത്തിന്, അടുത്ത കാലം വരെ, സ്പുട്നിക് എന്ന പദത്തിനായുള്ള ഒരു തിരച്ചിൽ റഷ്യൻ കാരിയർ റോക്കറ്റിനെക്കുറിച്ചുള്ള ഫലങ്ങൾ നൽകുമായിരുന്നു. എന്നിരുന്നാലും, പോസ്റ്റ്-പാൻഡെമിക് തിരയൽ ഫലങ്ങൾ തികച്ചും വ്യത്യസ്തവും റഷ്യൻ കോവിഡ് വാക്സിൻ നിറഞ്ഞതുമായിരിക്കും.
ഡാറ്റ ലേബൽ ചെയ്യുന്നതിലെ പക്ഷപാതം
പരിശീലന ഡാറ്റയിലെ പക്ഷപാതം എന്നത് ഇടയ്ക്കിടെ ഉയർന്നുവരുന്ന ഒരു വിഷയമാണ്. ലേബലിംഗ് പ്രക്രിയയ്ക്കോ വ്യാഖ്യാനങ്ങൾ വഴിയോ ഡാറ്റാ ബയസ് പ്രേരിപ്പിച്ചേക്കാം. വ്യാഖ്യാനകരുടെ ഒരു വലിയ വൈവിധ്യമാർന്ന ടീം ഉപയോഗിക്കുമ്പോഴോ അല്ലെങ്കിൽ ലേബലിംഗിന് ഒരു പ്രത്യേക സന്ദർഭം ആവശ്യമുള്ളപ്പോഴോ ഡാറ്റാ ബയസ് സംഭവിക്കാം.
ലോകമെമ്പാടുമുള്ള അനോട്ടേറ്റർമാർ അല്ലെങ്കിൽ പ്രദേശാധിഷ്ഠിത അനോട്ടേറ്റർമാർ ജോലികൾ നിർവഹിക്കുമ്പോൾ ബയസ് കുറയ്ക്കൽ സാധ്യമാണ്. നിങ്ങൾ ലോകമെമ്പാടുമുള്ള ഡാറ്റാസെറ്റുകൾ ഉപയോഗിക്കുകയാണെങ്കിൽ, ലേബലിംഗിൽ അനോട്ടേറ്റർമാർ തെറ്റുകൾ വരുത്താനുള്ള സാധ്യത വളരെ കൂടുതലാണ്.
ഉദാഹരണത്തിന്, നിങ്ങൾ ലോകമെമ്പാടുമുള്ള വിവിധ പാചകരീതികളിൽ പ്രവർത്തിക്കുന്നുണ്ടെങ്കിൽ, യുകെയിലെ ഒരു വ്യാഖ്യാനകന് ഏഷ്യക്കാരുടെ ഭക്ഷണ മുൻഗണനകളെക്കുറിച്ച് പരിചിതമായിരിക്കില്ല. തത്ഫലമായുണ്ടാകുന്ന ഡാറ്റാസെറ്റിന് ഇംഗ്ലീഷുകാർക്ക് അനുകൂലമായ ഒരു പക്ഷപാതം ഉണ്ടാകും.
AI പരിശീലന ഡാറ്റ പിശകുകൾ എങ്ങനെ ഒഴിവാക്കാം?
പരിശീലന ഡാറ്റ പിശകുകൾ ഒഴിവാക്കുന്നതിനുള്ള ഏറ്റവും നല്ല മാർഗം ലേബലിംഗ് പ്രക്രിയയുടെ ഓരോ ഘട്ടത്തിലും കർശനമായ ഗുണനിലവാര നിയന്ത്രണ പരിശോധനകൾ നടപ്പിലാക്കുക എന്നതാണ്.
വ്യാഖ്യാനകർക്ക് വ്യക്തവും കൃത്യവുമായ നിർദ്ദേശങ്ങൾ നൽകുന്നതിലൂടെ നിങ്ങൾക്ക് ഡാറ്റ ലേബലിംഗ് പിശകുകൾ ഒഴിവാക്കാൻ കഴിയും . ഇത് ഡാറ്റാസെറ്റിന്റെ ഏകീകൃതതയും കൃത്യതയും ഉറപ്പാക്കും.
ഡാറ്റാസെറ്റുകളിലെ അസന്തുലിതാവസ്ഥ ഒഴിവാക്കാൻ, പുതിയതും, പുതുക്കിയതും, പ്രതിനിധീകരിക്കുന്നതുമായ ഡാറ്റാസെറ്റുകൾ വാങ്ങുക. ML മോഡലുകൾ പരിശീലിപ്പിക്കുന്നതിനും പരീക്ഷിക്കുന്നതിനും മുമ്പ് ഡാറ്റാസെറ്റുകൾ പുതിയതും ഉപയോഗിക്കാത്തതുമാണെന്ന് ഉറപ്പാക്കുക.
മികച്ച പ്രകടനം കാഴ്ചവയ്ക്കുന്നതിന് പുതിയതും പക്ഷപാതമില്ലാത്തതും വിശ്വസനീയവുമായ പരിശീലന ഡാറ്റയെ അടിസ്ഥാനമാക്കിയാണ് ശക്തമായ ഒരു AI പ്രോജക്റ്റ് വളരുന്നത്. ഓരോ ലേബലിംഗ്, ടെസ്റ്റിംഗ് ഘട്ടത്തിലും വിവിധ ഗുണനിലവാര പരിശോധനകളും നടപടികളും നടത്തേണ്ടത് നിർണായകമാണ്. പരിശീലന പിശകുകൾ തിരിച്ചറിഞ്ഞ് പ്രോജക്റ്റിന്റെ ഫലത്തെ ബാധിക്കുന്നതിനുമുമ്പ് അവ തിരുത്തിയില്ലെങ്കിൽ അവ ഒരു പ്രധാന പ്രശ്നമായി മാറിയേക്കാം.
നിങ്ങളുടെ ML-അധിഷ്ഠിത പ്രോജക്റ്റിനായി ഗുണനിലവാരമുള്ള AI പരിശീലന ഡാറ്റാസെറ്റുകൾ ഉറപ്പാക്കാനുള്ള ഏറ്റവും നല്ല മാർഗം , പ്രോജക്റ്റിന് ആവശ്യമായ ഡൊമെയ്ൻ പരിജ്ഞാനവും അനുഭവപരിചയവുമുള്ള വൈവിധ്യമാർന്ന ഒരു കൂട്ടം വ്യാഖ്യാനകരെ നിയമിക്കുക എന്നതാണ്.
വൈവിധ്യമാർന്ന AI-അധിഷ്ഠിത പ്രോജക്റ്റുകൾക്ക് ഇന്റലിജന്റ് ലേബലിംഗ്, അനോട്ടേഷൻ സേവനങ്ങൾ നൽകുന്ന Shaip- ലെ പരിചയസമ്പന്നരായ അനോട്ടർമാരുടെ ടീമിനൊപ്പം നിങ്ങൾക്ക് വേഗത്തിൽ വിജയം നേടാൻ കഴിയും . ഞങ്ങളെ വിളിക്കൂ, നിങ്ങളുടെ AI പ്രോജക്റ്റുകളിൽ ഗുണനിലവാരവും പ്രകടനവും ഉറപ്പാക്കുക.