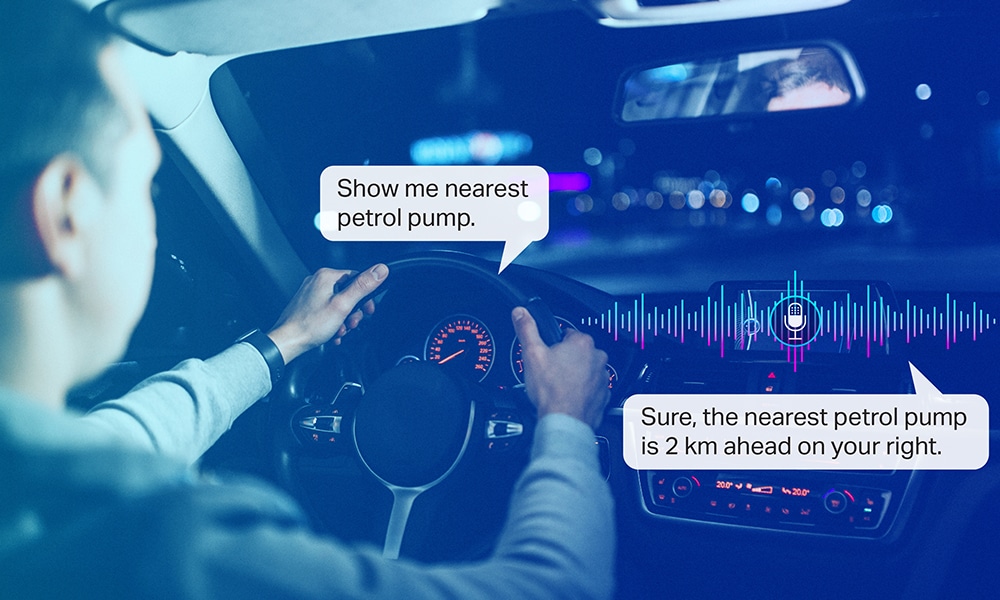
ഇന്നത്തെ വേഗതയേറിയതും സാങ്കേതികവിദ്യാധിഷ്ഠിതവുമായ ലോകത്ത്, അലക്സ, സിരി, ഗൂഗിൾ ഹോം തുടങ്ങിയ സംഭാഷണ AI ആപ്ലിക്കേഷനുകൾ നമ്മുടെ ദൈനംദിന ജീവിതത്തിൽ ഒഴിച്ചുകൂടാനാവാത്തതായി മാറിയിരിക്കുന്നു. അവ ജോലികൾ ലളിതമാക്കുകയും തൽക്ഷണ പരിഹാരങ്ങൾ നൽകുകയും മെഷീനുകളുമായി നമ്മൾ ഇടപഴകുന്ന രീതി മെച്ചപ്പെടുത്തുകയും ചെയ്യുന്നു. എന്നാൽ തടസ്സമില്ലാത്ത അനുഭവത്തിന് പിന്നിൽ ബുദ്ധിപരവും സംഭാഷണപരവുമായ സംവിധാനങ്ങൾ നിർമ്മിക്കുമ്പോൾ ഡെവലപ്പർമാർ നേരിടുന്ന വെല്ലുവിളികളുടെ ഒരു ശൃംഖലയുണ്ട്.
ബുദ്ധിപരവും, ബഹുഭാഷാപരവും, വൈകാരികമായി ബുദ്ധിപരവുമായ ചാറ്റ് അസിസ്റ്റന്റുമാരുടെ ആവശ്യം വർദ്ധിക്കുന്നതിനനുസരിച്ച്, ഈ ഉപകരണങ്ങൾ സൃഷ്ടിക്കുന്നതിലെ തടസ്സങ്ങളും അവ ഫലപ്രദമായി എങ്ങനെ മറികടക്കാമെന്നും മനസ്സിലാക്കേണ്ടത് അത്യാവശ്യമാണ്. ഈ ഗൈഡിൽ, സംഭാഷണ AI-യിലെ ഏറ്റവും പ്രധാനപ്പെട്ട ഡാറ്റാ വെല്ലുവിളികൾ ഞങ്ങൾ പര്യവേക്ഷണം ചെയ്യുകയും ഉപയോക്താക്കളുമായി യഥാർത്ഥത്തിൽ പ്രതിധ്വനിക്കുന്ന AI മോഡലുകൾ നിർമ്മിക്കുന്നതിന് പ്രവർത്തനക്ഷമമായ പരിഹാരങ്ങൾ നൽകുകയും ചെയ്യും.
സംഭാഷണ AI-യിലെ ഏറ്റവും സാധാരണമായ ഡാറ്റ വെല്ലുവിളികൾ

1. ഭാഷകളുടെയും ഉപഭാഷകളുടെയും വൈവിധ്യം
സംഭാഷണ AI-യിലെ ഏറ്റവും വലിയ വെല്ലുവിളികളിലൊന്ന് ലോകമെമ്പാടും സംസാരിക്കുന്ന ഭാഷകളുടെ വൈവിധ്യമാണ്. ഏകദേശം 1.35 ബില്യൺ ആളുകൾ ഒന്നാം ഭാഷയോ രണ്ടാം ഭാഷയോ ആയി ഇംഗ്ലീഷ് സംസാരിക്കുന്നുണ്ടെങ്കിലും, ലോക ജനസംഖ്യയുടെ 20% ൽ താഴെ മാത്രമേ ഇത് വരുന്നുള്ളൂ. ഇത് മറ്റ് ഭാഷകളിൽ ആശയവിനിമയം നടത്തുന്ന കോടിക്കണക്കിന് സാധ്യതയുള്ള ഉപയോക്താക്കളെ നിലനിർത്തുന്നു, പലപ്പോഴും അതുല്യമായ ഭാഷാഭേദങ്ങൾ, സ്ലാംഗ്, സാംസ്കാരിക സൂക്ഷ്മതകൾ എന്നിവയാൽ സമ്പന്നമാണ്.
പരിഹാരം:
ഈ വിടവ് നികത്താൻ, ബിസിനസുകൾക്ക് പ്രധാന ഭാഷകൾ മാത്രമല്ല, പ്രാദേശിക ഭാഷകളും പ്രാദേശിക ഭാഷകളും ഉൾക്കൊള്ളുന്ന വിശാലവും ഉയർന്ന നിലവാരമുള്ളതുമായ ബഹുഭാഷാ ഡാറ്റാസെറ്റുകളിലേക്ക് പ്രവേശനം ആവശ്യമാണ്. ആഗോള വിപണികൾക്കായി തയ്യാറാക്കിയ പ്രീ-അനോട്ടേറ്റഡ് സ്പീച്ച് ഡാറ്റാസെറ്റുകൾ പ്രയോജനപ്പെടുത്തുന്നത് സംഭാഷണ AI മോഡലുകളുടെ ഉൾപ്പെടുത്തലും വൈവിധ്യവും മെച്ചപ്പെടുത്തും.
2. ഭാഷാ ചലനാത്മകത പിടിച്ചെടുക്കൽ
ഭാഷകൾ ജീവസുറ്റതാണ് - അവ കാലത്തിനനുസരിച്ച് പരിണമിക്കുന്നു, ഭാഷ ഉൾക്കൊള്ളുന്നു, വികാരങ്ങളെ പ്രതിഫലിപ്പിക്കുന്നു. സ്വരം, പരിഹാസം, വികാരം തുടങ്ങിയ സൂക്ഷ്മമായ സൂക്ഷ്മതകളെ വ്യാഖ്യാനിക്കാൻ പാടുപെടുന്ന AI മോഡലുകൾക്ക് ഈ ചലനാത്മകത ഒരു വെല്ലുവിളി ഉയർത്തുന്നു. വാക്കുകൾക്കപ്പുറം മനുഷ്യർ ആശയവിനിമയം നടത്തുന്നു, ഈ "മാനുഷിക ഘടകം" പിടിച്ചെടുക്കുന്നതിൽ പരാജയപ്പെടുന്നത് വ്യക്തിത്വമില്ലാത്തതോ അപ്രസക്തമോ ആയ പ്രതികരണങ്ങളിലേക്ക് നയിച്ചേക്കാം.
പരിഹാരം:
വൈകാരികവും, സന്ദർഭോചിതവും, സാംസ്കാരികവുമായ വ്യതിയാനങ്ങളുടെ യഥാർത്ഥ ലോക ഉദാഹരണങ്ങൾ ഉൾക്കൊള്ളുന്ന ഡാറ്റാസെറ്റുകൾ ഉപയോഗിച്ച് നിങ്ങളുടെ AI പരിശീലിപ്പിക്കുക. വൈകാരികമായി ബുദ്ധിമാനായ AI പരിശീലന ഡാറ്റാസെറ്റുകൾ ഉൾപ്പെടുത്തുന്നത് നിങ്ങളുടെ സംഭാഷണ സഹായിയെ ഉപയോക്തൃ അന്വേഷണങ്ങൾക്ക് പിന്നിലെ ആഴത്തിലുള്ള സന്ദർഭം മനസ്സിലാക്കുന്നുവെന്ന് ഉറപ്പാക്കുന്നു, ഇത് കൂടുതൽ സ്വാഭാവികവും അർത്ഥവത്തായതുമായ ഇടപെടലുകൾക്ക് കാരണമാകുന്നു.
3. പശ്ചാത്തല ശബ്ദവും ഇടപെടലും
കുരയ്ക്കുന്ന നായ്ക്കളും ഡോർബെല്ലുകളും മുതൽ ഓവർലാപ്പുചെയ്യുന്ന സംഭാഷണങ്ങൾ വരെ, യഥാർത്ഥ ലോകത്തിലെ ഓഡിയോ വളരെ അപൂർവമായി മാത്രമേ പ്രാകൃതമായി കാണപ്പെടുന്നുള്ളൂ. ഈ പശ്ചാത്തല ശബ്ദങ്ങൾ പലപ്പോഴും ശബ്ദ തിരിച്ചറിയൽ സംവിധാനങ്ങളെ തടസ്സപ്പെടുത്തുകയും സംഭാഷണ AI യുടെ കൃത്യത കുറയ്ക്കുകയും ചെയ്യുന്നു. കൂടാതെ, ഒരേ പരിതസ്ഥിതിയിൽ ഒന്നിലധികം ശബ്ദ സഹായികൾ ഒരുമിച്ച് നിലനിൽക്കുന്നതിനാൽ, മത്സരിക്കുന്ന ഉപകരണങ്ങളിൽ നിന്ന് ഉപയോക്തൃ കമാൻഡുകളെ വേർതിരിച്ചറിയുന്നത് ബുദ്ധിമുട്ടായിരിക്കും.
പരിഹാരം:
ഉയർന്ന നിലവാരമുള്ളതും യഥാർത്ഥ ലോക ഓഡിയോ ഡാറ്റാസെറ്റുകളുമായി സംയോജിപ്പിച്ച വിപുലമായ നോയ്സ്-ഫിൽട്ടറിംഗ് അൽഗോരിതങ്ങൾ, പശ്ചാത്തല ശബ്ദത്തേക്കാൾ മനുഷ്യ കമാൻഡുകൾ തിരിച്ചറിയാനും മുൻഗണന നൽകാനും നിങ്ങളുടെ AI-യെ പരിശീലിപ്പിക്കാൻ സഹായിക്കും. വൈവിധ്യമാർന്ന അക്കൗസ്റ്റിക് പരിതസ്ഥിതികൾ ഉൾപ്പെടുന്ന ശക്തമായ വോയ്സ് റെക്കഗ്നിഷൻ മോഡലുകൾ രൂപകൽപ്പന ചെയ്യുന്നത് ഈ വെല്ലുവിളിയെ മറികടക്കുന്നതിന് നിർണായകമാണ്.
4. ഓഡിയോ സിൻക്രൊണൈസേഷൻ പ്രശ്നങ്ങൾ
ടെലിഫോണിക് സംഭാഷണങ്ങൾ ഉപയോഗിച്ച് AI ഉപകരണങ്ങൾ പരിശീലിപ്പിക്കുമ്പോൾ, വിളിക്കുന്നയാളിൽ നിന്നും ഏജന്റിൽ നിന്നുമുള്ള ഓഡിയോ സമന്വയിപ്പിക്കുന്നത് പ്രശ്നകരമാകും. തെറ്റായി ക്രമീകരിച്ച ഓഡിയോ ഡാറ്റ സംഭാഷണ പ്രവാഹം മനസ്സിലാക്കുന്നതിൽ വിടവുകൾ സൃഷ്ടിക്കുന്നു, ഇത് നിങ്ങളുടെ മോഡലിനെ പരിശീലിപ്പിക്കുന്നതിൽ കാര്യക്ഷമതയില്ലായ്മയിലേക്ക് നയിക്കുന്നു.
പരിഹാരം:
ഡ്യുവൽ-ചാനൽ ഓഡിയോയ്ക്കായി പ്രീ-സിൻക്രൊണൈസ് ചെയ്ത് വ്യാഖ്യാനിച്ച ഡാറ്റാസെറ്റുകളിൽ നിക്ഷേപിക്കുക. സംഭാഷണങ്ങൾ കൃത്യമായി വിന്യസിച്ചിട്ടുണ്ടെന്നും പരിശീലനത്തിന് തയ്യാറാണെന്നും ഇത് ഉറപ്പാക്കുന്നു, മാനുവൽ അധ്വാനം കുറയ്ക്കുകയും മോഡലിന്റെ പ്രകടനം മെച്ചപ്പെടുത്തുകയും ചെയ്യുന്നു.
5. ഡൊമെയ്ൻ-നിർദ്ദിഷ്ട ഡാറ്റയുടെ അഭാവം
സംഭാഷണ AI എല്ലാത്തിനും അനുയോജ്യമല്ല. പൊതുവായ ഉദ്ദേശ്യ ചാറ്റ്ബോട്ടുകൾ ലളിതമായ ജോലികളിൽ മികച്ച പ്രകടനം കാഴ്ചവയ്ക്കുമ്പോൾ, ആരോഗ്യ സംരക്ഷണം, ധനകാര്യം അല്ലെങ്കിൽ ഓട്ടോമോട്ടീവ് വ്യവസായങ്ങൾ എന്നിങ്ങനെയുള്ള വ്യവസായ-നിർദ്ദിഷ്ട ചോദ്യങ്ങൾക്ക് കൃത്യമായ ഉത്തരങ്ങൾ നൽകുന്നതിൽ അവ പലപ്പോഴും പരാജയപ്പെടുന്നു.
പരിഹാരം:
വ്യവസായ-നിർദ്ദിഷ്ട AI ആപ്ലിക്കേഷനുകൾ നിർമ്മിക്കുന്നതിന്, ആ ഡൊമെയ്നിന്റെ പദാവലി, പ്രക്രിയകൾ, ഉപയോക്തൃ പ്രതീക്ഷകൾ എന്നിവ പ്രതിഫലിപ്പിക്കുന്ന ഇഷ്ടാനുസൃത ഡാറ്റാസെറ്റുകൾ നിങ്ങൾക്ക് ആവശ്യമാണ് . ഉദാഹരണത്തിന്, വ്യാഖ്യാനിച്ച മെഡിക്കൽ സംഭാഷണങ്ങളോ EHR ഡാറ്റാസെറ്റുകളോ ഉപയോഗിച്ച് നിങ്ങളുടെ ആരോഗ്യ സംരക്ഷണ ചാറ്റ്ബോട്ടിനെ പരിശീലിപ്പിക്കുന്നത് അതിന്റെ കൃത്യതയും പ്രസക്തിയും ഗണ്യമായി വർദ്ധിപ്പിക്കും.
[ഇതും വായിക്കുക: AI- പവർഡ് ടെലിമെഡിസിൻ: ഉപയോഗ കേസുകൾ, നേട്ടങ്ങൾ, യഥാർത്ഥ വെല്ലുവിളികൾ ]
ഉപഭോക്താക്കളിൽ ഡാറ്റാ വെല്ലുവിളികളുടെ സ്വാധീനം
ഒന്നിലധികം ഓപ്ഷനുകൾ നൽകുന്ന ടെക്സ്റ്റ് അധിഷ്ഠിത സെർച്ച് എഞ്ചിനുകളിൽ നിന്ന് വ്യത്യസ്തമായി, സംഭാഷണ AI ഒരൊറ്റ കൃത്യമായ പ്രതികരണം നൽകുമെന്ന് പ്രതീക്ഷിക്കുന്നു. അടിസ്ഥാന ഡാറ്റാസെറ്റുകൾ പക്ഷപാതപരമോ അപൂർണ്ണമോ ആയിരിക്കുമ്പോൾ, ഫലങ്ങൾ തെറ്റിദ്ധരിപ്പിക്കുന്നതോ, അപ്രസക്തമോ, ഉപയോക്താക്കളെ നിരാശപ്പെടുത്തുന്നതോ ആകാം. ഈ കൃത്യതയുടെ അഭാവം ഉപയോക്തൃ വിശ്വാസ്യത കുറയ്ക്കുക മാത്രമല്ല, ബ്രാൻഡ് പ്രശസ്തിയെയും ബാധിക്കുന്നു.
ബിസിനസുകളെ സംബന്ധിച്ചിടത്തോളം, ഓഹരികൾ വ്യക്തമാണ്: മികച്ച ഡാറ്റ മികച്ച ഉപഭോക്തൃ അനുഭവങ്ങളിലേക്ക് നയിക്കുന്നു . ഡാറ്റ ശേഖരണത്തിലും മോഡൽ പരിശീലന ഘട്ടങ്ങളിലും ഈ വെല്ലുവിളികളെ അഭിമുഖീകരിക്കുന്നത് നിങ്ങളുടെ സംഭാഷണ AI അതിന്റെ ഉപയോക്താക്കൾക്ക് സ്ഥിരമായി മൂല്യം നൽകുന്നുവെന്ന് ഉറപ്പാക്കുന്നു.
ഡാറ്റാ വെല്ലുവിളികളെ എങ്ങനെ മറികടക്കാം, കൂടുതൽ മികച്ച AI എങ്ങനെ നിർമ്മിക്കാം
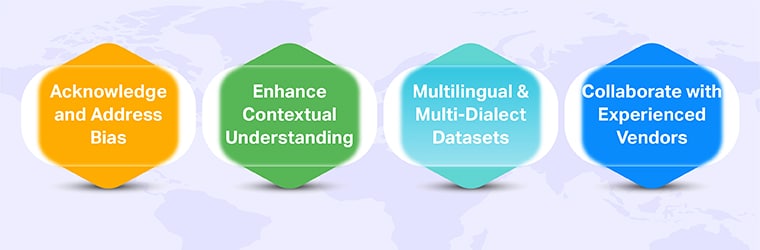
1. പക്ഷപാതം അംഗീകരിക്കുകയും അഭിസംബോധന ചെയ്യുകയും ചെയ്യുക
മികച്ച AI നിർമ്മിക്കുന്നതിനുള്ള ആദ്യപടി ഡാറ്റാസെറ്റുകളിൽ ബയസിന്റെ സാന്നിധ്യം തിരിച്ചറിയുക എന്നതാണ്. ഉപയോക്തൃ ഫീഡ്ബാക്ക് ലൂപ്പുകൾ, ഇഷ്ടാനുസൃതമാക്കാവുന്ന ക്രമീകരണങ്ങൾ എന്നിവ പോലുള്ള ബയസ് ഡിറ്റക്ഷൻ, ലഘൂകരണ തന്ത്രങ്ങൾ മുൻകൈയെടുത്ത് അവതരിപ്പിക്കുന്നത് വളച്ചൊടിച്ച ഫലങ്ങൾ തടയാൻ സഹായിക്കും.
2. സന്ദർഭോചിതമായ ധാരണ വർദ്ധിപ്പിക്കുക
സന്ദർഭോചിത സംഭാഷണങ്ങൾ മനസ്സിലാക്കാൻ നിങ്ങളുടെ മോഡലിനെ പരിശീലിപ്പിക്കേണ്ടത് വളരെ പ്രധാനമാണ്. മൾട്ടി-സ്പീക്കർ സംഭാഷണങ്ങളും സ്വയമേവയുള്ള സംഭാഷണങ്ങളും ഉൾപ്പെടെ യഥാർത്ഥ ലോക ഇടപെടൽ പാറ്റേണുകളെ പ്രതിഫലിപ്പിക്കുന്ന ഡാറ്റാസെറ്റുകൾ ഉൾപ്പെടുത്തുന്നതിലൂടെ ഇത് നേടാനാകും.
3. ബഹുഭാഷാ, ബഹുഭാഷാ ഡാറ്റാസെറ്റുകളിൽ നിക്ഷേപിക്കുക
വൈവിധ്യമാർന്ന ഡാറ്റാസെറ്റുകൾ ഉപയോഗിച്ച് നിങ്ങളുടെ ഭാഷാ കവറേജ് വികസിപ്പിക്കുന്നത് ആഗോള പ്രേക്ഷകരിലേക്ക് എത്തിച്ചേരുന്നതിന് പ്രധാനമാണ്. ബഹുഭാഷാ സംഭാഷണ AI പരിശീലന ഡാറ്റാസെറ്റുകളിൽ വൈദഗ്ദ്ധ്യം നേടിയ ഡാറ്റ ദാതാക്കളുമായി പങ്കാളിത്തം സ്ഥാപിക്കുന്നതിലൂടെ , ബിസിനസുകൾക്ക് വൈവിധ്യമാർന്ന വിപണികൾക്കായി അവരുടെ AI പരിഹാരങ്ങൾ സ്കെയിൽ ചെയ്യാൻ കഴിയും.
4. പരിചയസമ്പന്നരായ വെണ്ടർമാരുമായി സഹകരിക്കുക
സംഭാഷണപരമായ AI ഡാറ്റ ശേഖരണത്തിനായി പരിചയസമ്പന്നനായ ഒരു പങ്കാളിയുമായി പ്രവർത്തിക്കുന്നത് ശേഖരണവും വ്യാഖ്യാന പ്രക്രിയയും ഗണ്യമായി സുഗമമാക്കും. നിങ്ങളുടെ പ്രത്യേക ആവശ്യങ്ങൾക്കനുസൃതമായി ഉയർന്ന നിലവാരമുള്ളതും ഇഷ്ടാനുസൃതമാക്കാവുന്നതുമായ ഡാറ്റാസെറ്റുകൾ സൃഷ്ടിക്കുന്നതിൽ പരിചയസമ്പന്നരായ വെണ്ടർമാർ വൈദഗ്ദ്ധ്യം കൊണ്ടുവരുന്നു. ഇത് ചെലവ് കുറയ്ക്കുക മാത്രമല്ല, നിങ്ങളുടെ AI പരിഹാരങ്ങൾക്കായുള്ള സമയ-മാർക്കറ്റ് ത്വരിതപ്പെടുത്തുകയും ചെയ്യുന്നു.
[ഇതും വായിക്കുക: ആരോഗ്യ സംരക്ഷണത്തിന്റെ ഗുണനിലവാരം വർദ്ധിപ്പിക്കുന്നതിൽ AI- അധിഷ്ഠിത വോയ്സ് അസിസ്റ്റന്റുമാരുടെ ഉയർച്ച ]
സംഭാഷണ AI യുടെ ഭാവി രൂപപ്പെടുത്തുന്ന പ്രവണതകൾ
- വോയ്സ് ബയോമെട്രിക്സ്: സുരക്ഷയും വ്യക്തിഗതമാക്കലും വർദ്ധിപ്പിക്കുന്നതിനായി AI സംവിധാനങ്ങൾ വോയ്സ് ബയോമെട്രിക്സിനെ സംയോജിപ്പിക്കുന്നു. ബയോമെട്രിക് ഡാറ്റാസെറ്റുകൾ ഉപയോഗിച്ച്, കമ്പനികൾക്ക് വ്യക്തിഗത ഉപയോക്താക്കളെ അവരുടെ തനതായ വോക്കൽ പാറ്റേണുകൾ ഉപയോഗിച്ച് തിരിച്ചറിയുന്ന AI പരിഹാരങ്ങൾ സൃഷ്ടിക്കാൻ കഴിയും.
- മൾട്ടിമോഡൽ AI: സമ്പന്നവും കൂടുതൽ സംവേദനാത്മകവുമായ ഉപയോക്തൃ അനുഭവങ്ങൾ നൽകുന്നതിന് അടുത്ത തലമുറ സംഭാഷണ AI, വാചകം, ശബ്ദം, ദൃശ്യ ഇൻപുട്ടുകൾ എന്നിവ സംയോജിപ്പിക്കുന്നു. AI മോഡലുകൾക്ക് പരിശീലനം നൽകുന്നു മൾട്ടിമോഡൽ ഡാറ്റാസെറ്റുകൾ മുന്നിൽ നിൽക്കാൻ ലക്ഷ്യമിടുന്ന ബിസിനസുകൾക്ക് ഇത് ഒരു മുൻഗണനയായി മാറുകയാണ്.
- സംഭാഷണങ്ങൾക്കുള്ള ജനറേറ്റീവ് AI: ChatGPT പോലുള്ള ജനറേറ്റീവ് AI മോഡലുകൾ സംഭാഷണ സംവിധാനങ്ങളിൽ വിപ്ലവം സൃഷ്ടിക്കുന്നു. സംയോജിപ്പിക്കുന്നു. ഫൈൻ-ട്യൂൺ ചെയ്ത ജനറേറ്റീവ് AI ഡാറ്റാസെറ്റുകൾ നിങ്ങളുടെ ചാറ്റ് അസിസ്റ്റന്റിന് കൂടുതൽ മാനുഷികവും പൊരുത്തപ്പെടാവുന്നതുമായ പ്രതികരണങ്ങൾ സൃഷ്ടിക്കാനുള്ള കഴിവ് നൽകാൻ കഴിയും.

കൃത്യമായ സംഭാഷണ AI ഡാറ്റാസെറ്റുകൾക്കായി Shaip-മായി പങ്കാളിത്തം സ്ഥാപിക്കുക
സംഭാഷണ AI-യ്ക്കായി ഉയർന്ന നിലവാരമുള്ളതും പ്രത്യേകം തയ്യാറാക്കിയതുമായ ഡാറ്റാസെറ്റുകൾ നൽകുന്നതിൽ Shaip-ൽ ഞങ്ങൾ വൈദഗ്ദ്ധ്യം നേടിയിട്ടുണ്ട്. നിങ്ങൾ ഒരു ബഹുഭാഷാ ചാറ്റ്ബോട്ട് നിർമ്മിക്കുകയാണെങ്കിലും, ഒരു വോയ്സ് അസിസ്റ്റന്റ് ഫൈൻ-ട്യൂൺ ചെയ്യുകയാണെങ്കിലും അല്ലെങ്കിൽ ഒരു വ്യവസായ-നിർദ്ദിഷ്ട ആപ്ലിക്കേഷൻ രൂപകൽപ്പന ചെയ്യുകയാണെങ്കിലും, ഞങ്ങളുടെ വിപുലമായ സ്പീച്ച്, ഓഡിയോ, ടെക്സ്റ്റ് ഡാറ്റാസെറ്റുകളുടെ കാറ്റലോഗ് നിങ്ങളുടെ പ്രോജക്റ്റിനെ വിജയത്തിലേക്ക് നയിക്കും.
65-ലധികം ഭാഷകളിലും ഉപഭാഷകളിലും വൈദഗ്ധ്യമുള്ള ഷൈപ്, ഡാറ്റാ വെല്ലുവിളികളെ അതിജീവിക്കാനും സമഗ്രവും ബുദ്ധിപരവും സ്വാധീനം ചെലുത്തുന്നതുമായ AI പരിഹാരങ്ങൾ സൃഷ്ടിക്കാനും ബിസിനസുകളെ ശാക്തീകരിക്കുന്നു. സംഭാഷണ AI-യുടെ മുഴുവൻ സാധ്യതകളും പ്രയോജനപ്പെടുത്താൻ ഞങ്ങൾ നിങ്ങളെ സഹായിക്കട്ടെ.