

പ്ലെയിൻ ടെക്സ്റ്റിനുള്ളിലെ പ്രധാന വസ്തുതകൾ കണ്ടെത്തി അവ എന്താണെന്ന് ലേബൽ ചെയ്യുന്ന സ്വാഭാവിക ഭാഷാ പ്രോസസ്സിംഗ് (NLP) സാങ്കേതികതയാണ് നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ - ഒരു വ്യക്തി, ഒരു സ്ഥാപനം, ഒരു സ്ഥലം, ഒരു തീയതി, അല്ലെങ്കിൽ ഒരു ഡോളർ തുക. ഘടനാരഹിതമായ വാചകത്തിൽ "നാമമുള്ള എന്റിറ്റികൾ" കണ്ടെത്തി അവയെ മുൻകൂട്ടി നിശ്ചയിച്ച വിഭാഗങ്ങളായി തരംതിരിക്കുന്നതിനുള്ള NLP ടാസ്കാണ് നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ (NER). "NER പൂർണ്ണ രൂപം" എന്നത് ലളിതമായി പേരുള്ള എന്റിറ്റി റെക്കഗ്നിഷൻ ആണ്, കൂടാതെ മെഷീനുകൾ അസംസ്കൃത ഭാഷയെ ഘടനാപരവും ഉപയോഗയോഗ്യവുമായ ഡാറ്റയാക്കി മാറ്റുന്നതിന്റെ കാതലായ ഭാഗമാണിത്.
ഇപ്പോൾ ഇത് എന്തിനാണ് പ്രധാനമാകുന്നത്? കാരണം ടെക്സ്റ്റിനുള്ളിലെ മൂല്യം പൊട്ടിത്തെറിക്കുകയാണ്. 2024 ൽ ആഗോള NLP വിപണിയുടെ മൂല്യം 59.70 ബില്യൺ യുഎസ് ഡോളറായിരുന്നു, 2030 ആകുമ്പോഴേക്കും ഇത് 439.85 ബില്യൺ യുഎസ് ഡോളറിലെത്തുമെന്ന് പ്രതീക്ഷിക്കുന്നു, ഇത് 38.7% CAGR ആണ് (ഗ്രാൻഡ് വ്യൂ റിസർച്ച്, 2024) . സെർച്ച് എഞ്ചിനുകൾ, ചാറ്റ്ബോട്ടുകൾ, ക്ലിനിക്കൽ ഡാറ്റ പൈപ്പ്ലൈനുകൾ എന്നിവ നിശബ്ദമായി പവർ ചെയ്യുന്ന NER ആ വളർച്ചയെ നയിക്കുന്ന വർക്ക്ഹോഴ്സ് ടാസ്ക്കുകളിൽ ഒന്നാണ്.
NER നെ ഒരു ഹൈലൈറ്ററായി സങ്കൽപ്പിക്കുക, അത് ഒരേസമയം രണ്ട് ജോലികൾ ചെയ്യുന്നു: അത് പ്രധാനപ്പെട്ട വാക്കുകൾ അടയാളപ്പെടുത്തുകയും ഓരോന്നും എന്താണെന്ന് മാർജിനിൽ ഒരു കുറിപ്പ് എഴുതുകയും ചെയ്യുന്നു. ഒരു മനുഷ്യൻ ഇത് സഹജമായി ചെയ്യുന്നു. "സ്റ്റീവ് ജോബ്സ്" എന്ന് കേൾക്കുമ്പോൾ, നിങ്ങൾ ഉടൻ തന്നെ ആപ്പിളിനെ കാലിഫോർണിയയിലെ ഒരാളുമായി ബന്ധപ്പെടുത്തുന്നു. ഒരു കമ്പ്യൂട്ടറിന് അത്തരമൊരു സഹജാവബോധം ഇല്ല - ആ വിഭാഗങ്ങൾ കാണാൻ അതിനെ പരിശീലിപ്പിക്കണം, കൂടാതെ ആ പരിശീലനമാണ് ഗുണനിലവാരമുള്ള ഡാറ്റ വലിയ ജോലികൾ ചെയ്യുന്നത്.
കീ ടേക്ക്അവേസ്
- NER വാചകത്തിൽ ആളുകൾ, സ്ഥാപനങ്ങൾ, സ്ഥലങ്ങൾ, തീയതികൾ എന്നിങ്ങനെയുള്ള എന്റിറ്റികളെ തിരിച്ചറിയുകയും തരംതിരിക്കുകയും ചെയ്യുന്നു.
- "NER പൂർണ്ണ രൂപം" എന്നത് എന്റിറ്റി റെക്കഗ്നിഷൻ എന്നാണ് അറിയപ്പെടുന്നത്, ഇത് ഒരു പ്രധാന NLP ടാസ്കാണ്.
- ആധുനിക NER പ്രധാനമായും ആശ്രയിക്കുന്നത് BERT പോലുള്ള ആഴത്തിലുള്ള പഠനത്തെയും ട്രാൻസ്ഫോർമർ മോഡലുകളെയും ആണ്.
- BIO, IOBES പോലുള്ള ടാഗിംഗ് സ്കീമുകൾ ഓരോ എന്റിറ്റിയും എവിടെ ആരംഭിക്കുന്നുവെന്നും എവിടെ അവസാനിക്കുന്നുവെന്നും അടയാളപ്പെടുത്തുന്നു.
- NER നിലവാരം ഉയർന്ന നിലവാരമുള്ളതും നന്നായി വ്യാഖ്യാനിച്ചതുമായ പരിശീലന ഡാറ്റയെ ആശ്രയിച്ചിരിക്കുന്നു.
- സാധാരണ ഉപയോഗങ്ങൾ: തിരയൽ, ചാറ്റ്ബോട്ടുകൾ, ആരോഗ്യ സംരക്ഷണ രേഖകൾ, ധനകാര്യം, നിയമ അവലോകനം.
നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ (NER) എന്താണ്?
നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ നാച്ചുറൽ ലാംഗ്വേജ് പ്രോസസ്സിംഗിന്റെ ഒരു ഭാഗമാണ്. NER- ന്റെ പ്രാഥമിക ലക്ഷ്യം ഘടനാപരമായതും ഘടനയില്ലാത്തതുമായ ഡാറ്റ പ്രോസസ്സ് ചെയ്യുകയും ഈ പേരുള്ള എന്റിറ്റികളെ മുൻകൂട്ടി നിശ്ചയിച്ച വിഭാഗങ്ങളായി തരംതിരിക്കുകയും ചെയ്യുക എന്നതാണ്. ചില സാധാരണ വിഭാഗങ്ങളിൽ പേര്, സ്ഥലം, കമ്പനി, സമയം, പണ മൂല്യങ്ങൾ, ഇവന്റുകൾ എന്നിവയും അതിലേറെയും ഉൾപ്പെടുന്നു.
ചുരുക്കത്തിൽ, NER കൈകാര്യം ചെയ്യുന്നത്:
- പേരുള്ള എന്റിറ്റി തിരിച്ചറിയൽ/കണ്ടെത്തൽ - ഒരു പ്രമാണത്തിലെ ഒരു വാക്കോ പദങ്ങളുടെ പരമ്പരയോ തിരിച്ചറിയൽ.
- പേരുള്ള എന്റിറ്റി വർഗ്ഗീകരണം - കണ്ടെത്തിയ ഓരോ എന്റിറ്റിയെയും മുൻകൂട്ടി നിശ്ചയിച്ച വിഭാഗങ്ങളായി തരംതിരിക്കുന്നു.
എന്നാൽ NER NLP യുമായി എങ്ങനെ ബന്ധപ്പെട്ടിരിക്കുന്നു?
സംഭാഷണത്തിൽ നിന്നും വാചകത്തിൽ നിന്നും അർത്ഥം വേർതിരിച്ചെടുക്കാൻ കഴിവുള്ള ബുദ്ധിമാനായ യന്ത്രങ്ങളെ വികസിപ്പിക്കാൻ നാച്ചുറൽ ലാംഗ്വേജ് പ്രോസസ്സിംഗ് സഹായിക്കുന്നു. വലിയ അളവിലുള്ള സ്വാഭാവിക ഭാഷാ ഡാറ്റാസെറ്റുകളിൽ പരിശീലനം നൽകി പഠനം തുടരാൻ ഈ ബുദ്ധിമാനായ സംവിധാനങ്ങളെ മെഷീൻ ലേണിംഗ് സഹായിക്കുന്നു.
സാധാരണയായി, NLP മൂന്ന് പ്രധാന വിഭാഗങ്ങൾ ഉൾക്കൊള്ളുന്നു:
- ഭാഷയുടെ ഘടനയും നിയമങ്ങളും മനസ്സിലാക്കുക - പദവിന്യാസം
- വാക്കുകൾ, വാചകം, സംസാരം എന്നിവയുടെ അർത്ഥം കണ്ടെത്തുകയും അവയുടെ ബന്ധങ്ങൾ തിരിച്ചറിയുകയും ചെയ്യുന്നു - സെമാന്റിക്സ്
- സംസാരിക്കുന്ന വാക്കുകൾ തിരിച്ചറിയുകയും തിരിച്ചറിയുകയും അവയെ വാചകമാക്കി മാറ്റുകയും ചെയ്യുക - പ്രസംഗം
വാക്കുകളുടെ അർത്ഥം വേർതിരിച്ചെടുക്കുന്നതിനും അവയുടെ ബന്ധങ്ങളെ അടിസ്ഥാനമാക്കി അവയെ തിരിച്ചറിയുന്നതിനും കണ്ടെത്തുന്നതിനും NLP യുടെ സെമാന്റിക് ഭാഗത്ത് NER സഹായിക്കുന്നു.
സാധാരണ NER എൻ്റിറ്റി തരങ്ങളിലേക്ക് ആഴത്തിലുള്ള ഡൈവ്
പേരിട്ടിരിക്കുന്ന എൻ്റിറ്റി റെക്കഗ്നിഷൻ മോഡലുകൾ എൻ്റിറ്റികളെ വിവിധ മുൻകൂട്ടി നിശ്ചയിച്ച തരങ്ങളായി തരംതിരിക്കുന്നു. NER ഫലപ്രദമായി പ്രയോജനപ്പെടുത്തുന്നതിന് ഈ തരങ്ങൾ മനസ്സിലാക്കുന്നത് നിർണായകമാണ്. ഏറ്റവും സാധാരണമായവയിൽ ചിലത് ഇവിടെ അടുത്തറിയുന്നു:
- വ്യക്തി (PER): ആദ്യ, മധ്യ, അവസാന നാമങ്ങൾ, തലക്കെട്ടുകൾ, ബഹുമതികൾ എന്നിവ ഉൾപ്പെടെയുള്ള വ്യക്തികളുടെ പേരുകൾ തിരിച്ചറിയുന്നു. ഉദാഹരണം: നെൽസൺ മണ്ടേല, ഡോ. ജെയിൻ ഡോ
- ഓർഗനൈസേഷൻ (ORG): കമ്പനികൾ, സ്ഥാപനങ്ങൾ, സർക്കാർ ഏജൻസികൾ, മറ്റ് സംഘടിത ഗ്രൂപ്പുകൾ എന്നിവയെ അംഗീകരിക്കുന്നു. ഉദാഹരണം: ഗൂഗിൾ, ലോകാരോഗ്യ സംഘടന, ഐക്യരാഷ്ട്രസഭ
- സ്ഥാനം (LOC): രാജ്യങ്ങൾ, നഗരങ്ങൾ, സംസ്ഥാനങ്ങൾ, വിലാസങ്ങൾ, ലാൻഡ്മാർക്കുകൾ എന്നിവയുൾപ്പെടെ ഭൂമിശാസ്ത്രപരമായ സ്ഥാനങ്ങൾ കണ്ടെത്തുന്നു. ഉദാഹരണം: ലണ്ടൻ, മൗണ്ട് എവറസ്റ്റ്, ടൈംസ് സ്ക്വയർ
- തീയതി (DATE): വിവിധ ഫോർമാറ്റുകളിൽ തീയതികൾ എക്സ്ട്രാക്റ്റ് ചെയ്യുന്നു. ഉദാഹരണം: ജനുവരി 1, 2024, 2024-01-01
- സമയം (TIME): സമയ ഭാവങ്ങൾ തിരിച്ചറിയുന്നു. ഉദാഹരണം: 3:00 PM, 15:00
- അളവ് (QUANTITY): സംഖ്യാ അളവുകളും അളവുകളുടെ യൂണിറ്റുകളും തിരിച്ചറിയുന്നു. ഉദാഹരണം: 10 കിലോഗ്രാം, 2 ലിറ്റർ
- ശതമാനം (PERCENT): ശതമാനം കണ്ടുപിടിക്കുന്നു. ഉദാഹരണം: 50%, 0.5
- പണം (മണി): പണ മൂല്യങ്ങളും കറൻസികളും വേർതിരിച്ചെടുക്കുന്നു. ഉദാഹരണം: $100, €50
- മറ്റുള്ളവ (MISC): മറ്റ് തരങ്ങളുമായി പൊരുത്തപ്പെടാത്ത എൻ്റിറ്റികൾക്കുള്ള ക്യാച്ച്-എല്ലാ വിഭാഗം. ഉദാഹരണം: നോബൽ സമ്മാനം, iPhone 15″
പേരിട്ട എൻ്റിറ്റി തിരിച്ചറിയലിൻ്റെ ഉദാഹരണങ്ങൾ
മുൻകൂട്ടി നിശ്ചയിച്ച എന്റിറ്റി വർഗ്ഗീകരണത്തിന്റെ ചില സാധാരണ ഉദാഹരണങ്ങൾ ഇവയാണ്:
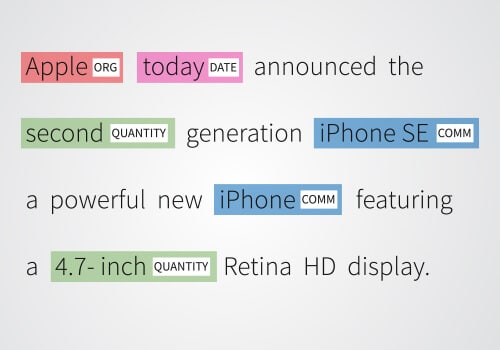
ആപ്പിൾ: ORG (ഓർഗനൈസേഷൻ) എന്ന് ലേബൽ ചെയ്ത് ചുവപ്പിൽ ഹൈലൈറ്റ് ചെയ്തിരിക്കുന്നു. ഇന്ന്: DATE എന്ന് ലേബൽ ചെയ്ത് പിങ്ക് നിറത്തിൽ ഹൈലൈറ്റ് ചെയ്തിരിക്കുന്നു. രണ്ടാമത്തേത്: QUANTITY എന്ന് ലേബൽ ചെയ്ത് പച്ച നിറത്തിൽ ഹൈലൈറ്റ് ചെയ്തിരിക്കുന്നു. iPhone SE: COMM (വാണിജ്യ ഉൽപ്പന്നം) എന്ന് ലേബൽ ചെയ്ത് നീല നിറത്തിൽ ഹൈലൈറ്റ് ചെയ്തിരിക്കുന്നു. 4.7-ഇഞ്ച്: QUANTITY എന്ന് ലേബൽ ചെയ്ത് പച്ച നിറത്തിൽ ഹൈലൈറ്റ് ചെയ്തിരിക്കുന്നു.
പേരിട്ട എന്റിറ്റി റെക്കഗ്നിഷനിലെ അവ്യക്തത
ഒരു പദം ഉൾപ്പെടുന്ന വിഭാഗം മനുഷ്യർക്ക് അവബോധപൂർവ്വം വളരെ വ്യക്തമാണ്. എന്നിരുന്നാലും, കമ്പ്യൂട്ടറുകളുടെ കാര്യം അങ്ങനെയല്ല - അവ വർഗ്ഗീകരണ പ്രശ്നങ്ങൾ നേരിടുന്നു. ഉദാഹരണത്തിന്:
മാഞ്ചസ്റ്റർ സിറ്റി ( ഓർഗനൈസേഷൻ ) പ്രീമിയർ ലീഗ് ട്രോഫി നേടി, എന്നാൽ അടുത്ത വാക്യത്തിൽ സംഘടന എന്ന പദം വ്യത്യസ്തമായി ഉപയോഗിച്ചിരിക്കുന്നു. മാഞ്ചസ്റ്റർ സിറ്റി ( സ്ഥലം ) ഒരു ടെക്സ്റ്റൈൽ, വ്യാവസായിക ശക്തികേന്ദ്രമായിരുന്നു.
കൃത്യമായ എന്റിറ്റി എക്സ്ട്രാക്ഷൻ നടത്താൻ നിങ്ങളുടെ NER മോഡലിന് പരിശീലന ഡാറ്റ ആവശ്യമാണ്, കൂടാതെ പഠിച്ച പാറ്റേണുകളെ അടിസ്ഥാനമാക്കി പേരുള്ള എന്റിറ്റികളെ തരംതിരിക്കുന്നു. ഷേക്സ്പിയർ ഇംഗ്ലീഷിൽ നിങ്ങളുടെ മോഡലിനെ പരിശീലിപ്പിക്കുകയാണെങ്കിൽ, അത് ഇൻസ്റ്റാഗ്രാമിനെ ഡീക്രിപ്റ്റ് ചെയ്യാൻ കഴിയില്ലെന്ന് പറയേണ്ടതില്ലല്ലോ. NER മോഡലുകളെ അവയുടെ പ്രവചനങ്ങളെ അടിസ്ഥാന സത്യ വ്യാഖ്യാനങ്ങളുമായി താരതമ്യം ചെയ്താണ് വിലയിരുത്തുന്നത്, അവ ഡാറ്റാസെറ്റിലെ ശരിയായ, മാനുവൽ ലേബൽ ചെയ്ത എന്റിറ്റികളാണ്.
നെയിംഡ്-എന്റിറ്റി റെക്കഗ്നിഷൻ എങ്ങനെയാണ് പ്രവർത്തിക്കുന്നത്?
നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷന്റെ (NER) മേഖലയിലേക്ക് കടക്കുന്നത് നിരവധി ഘട്ടങ്ങൾ ഉൾക്കൊള്ളുന്ന ഒരു ചിട്ടയായ യാത്ര അനാവരണം ചെയ്യുന്നു:
ടോക്കൺ ചെയ്യൽ
തുടക്കത്തിൽ, വാചക ഡാറ്റ ചെറിയ യൂണിറ്റുകളായി വിഭജിക്കപ്പെടുന്നു, ടോക്കണുകൾ എന്ന് വിളിക്കുന്നു, അവ വാക്കുകൾ മുതൽ വാക്യങ്ങൾ വരെ വ്യത്യാസപ്പെടാം. ഉദാഹരണത്തിന്, "ബരാക് ഒബാമ യുഎസ്എയുടെ പ്രസിഡന്റായിരുന്നു" എന്ന പ്രസ്താവനയെ "ബരാക്ക്", "ഒബാമ", "ആസ്", "ദി", "പ്രസിഡന്റ്", "ഓഫ്", "ദി", "എന്നിങ്ങനെയുള്ള ടോക്കണുകളായി തിരിച്ചിരിക്കുന്നു. യുഎസ്എ".
എന്റിറ്റി കണ്ടെത്തൽ
ഭാഷാപരമായ മാർഗ്ഗനിർദ്ദേശങ്ങളുടെയും സ്ഥിതിവിവരക്കണക്ക് രീതികളുടെയും ഒരു സംയോജനം ഉപയോഗപ്പെടുത്തി, സാധ്യതയുള്ള എന്റിറ്റികൾ ശ്രദ്ധിക്കപ്പെടുന്നു. പേരുകളിലെ ക്യാപിറ്റലൈസേഷൻ ("ബരാക് ഒബാമ") അല്ലെങ്കിൽ വ്യത്യസ്ത ഫോർമാറ്റുകൾ (തീയതികൾ പോലെ) പോലുള്ള പാറ്റേണുകൾ തിരിച്ചറിയുന്നത് ഈ ഘട്ടത്തിൽ നിർണായകമാണ്.
എന്റിറ്റി വർഗ്ഗീകരണം
കണ്ടെത്തലിനുശേഷം, എന്റിറ്റികളെ "വ്യക്തി", "ഓർഗനൈസേഷൻ" അല്ലെങ്കിൽ "ലൊക്കേഷൻ" എന്നിങ്ങനെ മുൻകൂട്ടി നിശ്ചയിച്ച വിഭാഗങ്ങളായി തരംതിരിച്ചിരിക്കുന്നു. മെഷീൻ ലേണിംഗ് മോഡലുകൾ, ലേബൽ ചെയ്ത ഡാറ്റാസെറ്റുകളിൽ പരിപോഷിപ്പിക്കപ്പെടുന്നു, പലപ്പോഴും ഈ വർഗ്ഗീകരണത്തെ നയിക്കുന്നു. ഇവിടെ, "ബരാക് ഒബാമ" ഒരു "വ്യക്തി" എന്നും "യുഎസ്എ" ഒരു "ലൊക്കേഷൻ" എന്നും ടാഗ് ചെയ്തിരിക്കുന്നു.
സന്ദർഭോചിതമായ വിലയിരുത്തൽ
ചുറ്റുമുള്ള സന്ദർഭങ്ങളെ വിലയിരുത്തുന്നതിലൂടെ NER സിസ്റ്റങ്ങളുടെ പ്രൗഢി പലപ്പോഴും വർദ്ധിപ്പിക്കപ്പെടുന്നു. ഉദാഹരണത്തിന്, "വാഷിംഗ്ടൺ ഒരു ചരിത്ര സംഭവത്തിന് സാക്ഷ്യം വഹിച്ചു" എന്ന വാചകത്തിൽ, ഒരു വ്യക്തിയുടെ പേരിനേക്കാൾ "വാഷിംഗ്ടൺ" എന്നത് ഒരു സ്ഥലമായി വിവേചിച്ചറിയാൻ സന്ദർഭം സഹായിക്കുന്നു.
മൂല്യനിർണ്ണയത്തിനു ശേഷമുള്ള പരിഷ്ക്കരണം
പ്രാഥമിക ഐഡന്റിഫിക്കേഷനും വർഗ്ഗീകരണത്തിനും ശേഷം, ഫലങ്ങൾ മെച്ചപ്പെടുത്തുന്നതിന് മൂല്യനിർണ്ണയത്തിനു ശേഷമുള്ള പരിഷ്കരണം ഉണ്ടായേക്കാം. ഈ ഘട്ടത്തിന് അവ്യക്തതകൾ പരിഹരിക്കാനും മൾട്ടി-ടോക്കൺ എന്റിറ്റികൾ സംയോജിപ്പിക്കാനും അല്ലെങ്കിൽ എന്റിറ്റി ഡാറ്റ വർദ്ധിപ്പിക്കുന്നതിന് വിജ്ഞാന അടിത്തറകൾ ഉപയോഗിക്കാനും കഴിയും.
ഈ നിർവചിക്കപ്പെട്ട സമീപനം NER-ന്റെ കാതൽ നിർവീര്യമാക്കുക മാത്രമല്ല, തിരയൽ എഞ്ചിനുകൾക്കുള്ള ഉള്ളടക്കം ഒപ്റ്റിമൈസ് ചെയ്യുകയും ചെയ്യുന്നു, NER ഉൾക്കൊള്ളുന്ന സങ്കീർണ്ണമായ പ്രക്രിയയുടെ ദൃശ്യപരത വർദ്ധിപ്പിക്കുന്നു.
പ്രധാന NER സമീപനങ്ങൾ എന്തൊക്കെയാണ്?
ഒരു NER മോഡലിന്റെ പ്രാഥമിക ലക്ഷ്യം ടെക്സ്റ്റ് ഡോക്യുമെന്റുകളിലെ എന്റിറ്റികളെ ലേബൽ ചെയ്യുകയും അവയെ വർഗ്ഗീകരിക്കുകയും ചെയ്യുക എന്നതാണ്. ഇതിനായി സാധാരണയായി താഴെപ്പറയുന്ന മൂന്ന് സമീപനങ്ങളാണ് ഉപയോഗിക്കുന്നത്. എന്നിരുന്നാലും, നിങ്ങൾക്ക് ഒന്നോ അതിലധികമോ രീതികൾ സംയോജിപ്പിക്കാൻ തിരഞ്ഞെടുക്കാം. NER സിസ്റ്റങ്ങൾ സൃഷ്ടിക്കുന്നതിനുള്ള വ്യത്യസ്ത സമീപനങ്ങൾ ഇവയാണ്:

നിഘണ്ടു അടിസ്ഥാനമാക്കിയുള്ള സംവിധാനങ്ങൾ
നിഘണ്ടു അടിസ്ഥാനമാക്കിയുള്ള സംവിധാനം ഒരുപക്ഷേ ഏറ്റവും ലളിതവും അടിസ്ഥാനപരവുമായ NER സമീപനമാണ്. ഇത് നിരവധി പദങ്ങളും പര്യായപദങ്ങളും പദാവലി ശേഖരണവും ഉള്ള ഒരു നിഘണ്ടു ഉപയോഗിക്കും. ടെക്സ്റ്റിൽ ഉള്ള ഒരു പ്രത്യേക എന്റിറ്റി പദാവലിയിലും ലഭ്യമാണോ എന്ന് സിസ്റ്റം പരിശോധിക്കും. ഒരു സ്ട്രിംഗ്-മാച്ചിംഗ് അൽഗോരിതം ഉപയോഗിച്ച്, എന്റിറ്റികളുടെ ക്രോസ്-ചെക്കിംഗ് നടത്തുന്നു.
ഈ സമീപനം ഉപയോഗിക്കുന്നതിന്റെ ഒരു പോരായ്മ, NER മോഡലിന്റെ ഫലപ്രദമായ പ്രവർത്തനത്തിനായി പദാവലി ഡാറ്റാസെറ്റ് നിരന്തരം നവീകരിക്കേണ്ടതിന്റെ ആവശ്യകതയാണ്.
നിയമാധിഷ്ഠിത സംവിധാനങ്ങൾ
ഈ സമീപനത്തിൽ, മുൻകൂട്ടി നിശ്ചയിച്ചിട്ടുള്ള ഒരു കൂട്ടം നിയമങ്ങളെ അടിസ്ഥാനമാക്കിയാണ് വിവരങ്ങൾ വേർതിരിച്ചെടുക്കുന്നത്. രണ്ട് പ്രാഥമിക നിയമങ്ങൾ ഉപയോഗിക്കുന്നു,
പാറ്റേൺ അടിസ്ഥാനമാക്കിയുള്ള നിയമങ്ങൾ - പേര് സൂചിപ്പിക്കുന്നത് പോലെ, ഒരു പാറ്റേൺ അടിസ്ഥാനമാക്കിയുള്ള നിയമം പ്രമാണത്തിൽ ഉപയോഗിച്ചിരിക്കുന്ന ഒരു രൂപഘടന പാറ്റേൺ അല്ലെങ്കിൽ പദങ്ങളുടെ ഒരു പരമ്പര പിന്തുടരുന്നു.
സന്ദർഭാധിഷ്ഠിത നിയമങ്ങൾ - പ്രമാണത്തിലെ പദത്തിന്റെ അർത്ഥത്തെയോ സന്ദർഭത്തെയോ ആശ്രയിച്ചിരിക്കും സന്ദർഭാധിഷ്ഠിത നിയമങ്ങൾ.
മെഷീൻ ലേണിംഗ് അധിഷ്ഠിത സംവിധാനങ്ങൾ
മെഷീൻ ലേണിംഗ് അധിഷ്ഠിത സിസ്റ്റങ്ങളിൽ, എന്റിറ്റികളെ കണ്ടെത്താൻ സ്റ്റാറ്റിസ്റ്റിക്കൽ മോഡലിംഗ് ഉപയോഗിക്കുന്നു. ഈ സമീപനത്തിൽ ടെക്സ്റ്റ് ഡോക്യുമെന്റിന്റെ സവിശേഷത അടിസ്ഥാനമാക്കിയുള്ള പ്രാതിനിധ്യം ഉപയോഗിക്കുന്നു. അക്ഷരവിന്യാസത്തിൽ ചെറിയ വ്യത്യാസങ്ങൾ ഉണ്ടെങ്കിലും മോഡലിന് എന്റിറ്റി തരങ്ങളെ തിരിച്ചറിയാൻ കഴിയുന്നതിനാൽ, ആദ്യത്തെ രണ്ട് സമീപനങ്ങളുടെ നിരവധി പോരായ്മകൾ നിങ്ങൾക്ക് മറികടക്കാൻ കഴിയും.
ആഴത്തിലുള്ള പഠനം
NER-നുള്ള ആഴത്തിലുള്ള പഠന രീതികൾ RNN-കൾ, ട്രാൻസ്ഫോർമറുകൾ എന്നിവ പോലുള്ള ന്യൂറൽ നെറ്റ്വർക്കുകളുടെ ശക്തിയെ ദീർഘകാല ടെക്സ്റ്റ് ഡിപൻഡൻസികൾ മനസ്സിലാക്കാൻ സഹായിക്കുന്നു. ഈ രീതികൾ ഉപയോഗിക്കുന്നതിൻ്റെ പ്രധാന നേട്ടം, സമൃദ്ധമായ പരിശീലന ഡാറ്റയുള്ള വലിയ തോതിലുള്ള NER ടാസ്ക്കുകൾക്ക് അവ നന്നായി യോജിക്കുന്നു എന്നതാണ്.
കൂടാതെ, അവർക്ക് ഡാറ്റയിൽ നിന്ന് തന്നെ സങ്കീർണ്ണമായ പാറ്റേണുകളും സവിശേഷതകളും പഠിക്കാൻ കഴിയും, ഇത് മാനുവൽ പരിശീലനത്തിൻ്റെ ആവശ്യകത ഇല്ലാതാക്കുന്നു. പക്ഷേ ഒരു പിടിയുണ്ട്. ഈ രീതികൾക്ക് പരിശീലനത്തിനും വിന്യാസത്തിനുമായി ഒരു വലിയ അളവിലുള്ള കമ്പ്യൂട്ടേഷണൽ പവർ ആവശ്യമാണ്.
ഹൈബ്രിഡ് രീതികൾ
പേരുള്ള എൻ്റിറ്റികൾ എക്സ്ട്രാക്റ്റുചെയ്യുന്നതിന് ഈ രീതികൾ റൂൾ-ബേസ്റ്റ്, സ്റ്റാറ്റിസ്റ്റിക്കൽ, മെഷീൻ ലേണിംഗ് പോലുള്ള സമീപനങ്ങളെ സംയോജിപ്പിക്കുന്നു. ഓരോ രീതിയുടെയും ബലഹീനതകൾ കുറയ്ക്കുമ്പോൾ അവയുടെ ശക്തികൾ സംയോജിപ്പിക്കുക എന്നതാണ് ലക്ഷ്യം. വൈവിധ്യമാർന്ന ഡാറ്റാ ഉറവിടങ്ങളിൽ നിന്ന് എൻ്റിറ്റികൾ എക്സ്ട്രാക്റ്റുചെയ്യാൻ കഴിയുന്ന ഒന്നിലധികം ടെക്നിക്കുകൾ ലയിപ്പിക്കുന്നതിലൂടെ നിങ്ങൾക്ക് ലഭിക്കുന്ന വഴക്കമാണ് ഹൈബ്രിഡ് രീതികൾ ഉപയോഗിക്കുന്നതിൻ്റെ ഏറ്റവും മികച്ച ഭാഗം.
എന്നിരുന്നാലും, നിങ്ങൾ ഒന്നിലധികം സമീപനങ്ങൾ ലയിപ്പിക്കുമ്പോൾ, വർക്ക്ഫ്ലോ ആശയക്കുഴപ്പത്തിലായേക്കാം എന്നതിനാൽ, ഈ രീതികൾ സിംഗിൾ അപ്രോച്ച് രീതികളേക്കാൾ കൂടുതൽ സങ്കീർണ്ണമാകാൻ സാധ്യതയുണ്ട്.
NER എവിടെയാണ് ഉപയോഗിക്കുന്നത്? ഏറ്റവും കൂടുതൽ ഉപയോഗിക്കുന്ന കേസുകളും വ്യവസായങ്ങളും
നാമകരണം ചെയ്യപ്പെട്ട സ്ഥാപന തിരിച്ചറിയലിന്റെ (NER) വൈവിധ്യം അനാവരണം ചെയ്യുന്നു.
ധനകാര്യം മുതൽ ആരോഗ്യ സംരക്ഷണം വരെയുള്ള വിവിധ മേഖലകളിൽ NER പ്രയോഗിക്കപ്പെടുന്നു, അതിന്റെ പൊരുത്തപ്പെടുത്തലും വിശാലമായ ഉപയോഗവും പ്രകടമാക്കുന്നു.
- ചാറ്റ്ബോട്ടുകൾ: പ്രധാന എൻ്റിറ്റികളെ തിരിച്ചറിയുന്നതിലൂടെ ഉപയോക്തൃ ചോദ്യങ്ങൾ മനസ്സിലാക്കാൻ GPT പോലുള്ള ചാറ്റ്ബോട്ടുകളെ സഹായിക്കുന്നു.
- ഉപഭോക്തൃ പിന്തുണ: പ്രതികരണ സമയം ത്വരിതപ്പെടുത്തിക്കൊണ്ട് ഉൽപ്പന്നം അനുസരിച്ച് ഫീഡ്ബാക്ക് തരംതിരിക്കുന്നു.
- ധനകാര്യം: ട്രെൻഡ് വിശകലനത്തിനും അപകടസാധ്യത വിലയിരുത്തുന്നതിനുമായി സാമ്പത്തിക റിപ്പോർട്ടുകളിൽ നിന്ന് നിർണായക ഡാറ്റ എക്സ്ട്രാക്റ്റുചെയ്യുന്നു.
- ആരോഗ്യ പരിരക്ഷ: ഇലക്ട്രോണിക് ഹെൽത്ത് റെക്കോർഡുകളിൽ (EHR) നിന്ന് രോഗിയുടെ ഡാറ്റ വേർതിരിച്ചെടുക്കൽ.
- എച്ച്ആർ: അപേക്ഷകരുടെ പ്രൊഫൈലുകൾ സംഗ്രഹിച്ചും ഫീഡ്ബാക്ക് ചാനലുകൾ വഴിയും റിക്രൂട്ട്മെൻ്റ് കാര്യക്ഷമമാക്കുന്നു.
- വാർത്താ ദാതാക്കൾ: ഉള്ളടക്കത്തെ പ്രസക്തമായ വിവരങ്ങളായി തരംതിരിക്കുന്നു, റിപ്പോർട്ടിംഗ് വേഗത്തിലാക്കുന്നു.
- ശുപാർശ എഞ്ചിനുകൾ: Netflix പോലുള്ള കമ്പനികൾ ഉപയോക്തൃ പെരുമാറ്റത്തെ അടിസ്ഥാനമാക്കി ശുപാർശകൾ വ്യക്തിഗതമാക്കാൻ NER ഉപയോഗിക്കുന്നു.
- സെർച്ച് എഞ്ചിനുകൾ: വെബ് ഉള്ളടക്കം വർഗ്ഗീകരിക്കുന്നതിലൂടെ, NER തിരയൽ ഫലങ്ങളുടെ കൃത്യത വർദ്ധിപ്പിക്കുന്നു.
- വികാര വിശകലനം: ഇxtracts ബ്രാൻഡ് അവലോകനങ്ങളിൽ നിന്നുള്ള പരാമർശങ്ങൾ, വികാര വിശകലന ടൂളുകൾക്ക് ഇന്ധനം പകരുന്നു.
- ഇ-കൊമേഴ്സ്: വ്യക്തിഗതമാക്കിയ ഷോപ്പിംഗ് അനുഭവങ്ങൾ മെച്ചപ്പെടുത്തുന്നു.
- നിയമ: കരാറുകളുടെയും നിയമപരമായ രേഖകളുടെയും വിശകലനം.
NER വഴി വേർതിരിച്ചെടുത്ത എന്റിറ്റികളെ വിജ്ഞാന ഗ്രാഫുകളിൽ സംയോജിപ്പിക്കാൻ കഴിയും, ഇത് മെച്ചപ്പെട്ട ഡാറ്റ ഓർഗനൈസേഷനും വീണ്ടെടുക്കലും പ്രാപ്തമാക്കുന്നു.
പേര് നൽകിയ എൻ്റിറ്റി റെക്കഗ്നിഷൻ (NER) ആരാണ് ഉപയോഗിക്കുന്നത്?
ശക്തമായ നാച്ചുറൽ ലാംഗ്വേജ് പ്രോസസ്സിംഗ് (NLP) ടെക്നിക്കുകളിൽ ഒന്നായ NER (നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ), വിവിധ വ്യവസായങ്ങളിലേക്കും ഡൊമെയ്നുകളിലേക്കും വഴിമാറി. വിവരങ്ങൾ ശേഖരിക്കുന്നത് ഓട്ടോമേറ്റ് ചെയ്യുന്നതിനും കാര്യക്ഷമത മെച്ചപ്പെടുത്തുന്നതിനും ഓർഗനൈസേഷനുകൾ പലപ്പോഴും ഒരു നാമകരണം ചെയ്ത എന്റിറ്റി റെക്കഗ്നിഷൻ സിസ്റ്റം വിന്യസിക്കുന്നു. ചില ഉദാഹരണങ്ങൾ ഇതാ:
- സെർച്ച് എഞ്ചിനുകൾ: ഗൂഗിൾ, ബിംഗ് പോലുള്ള ആധുനിക സെർച്ച് എഞ്ചിനുകളുടെ ഒരു പ്രധാന ഘടകമാണ് NER. കൂടുതൽ പ്രസക്തമായ തിരയൽ ഫലങ്ങൾ നൽകുന്നതിനായി വെബ് പേജുകളിൽ നിന്നും തിരയൽ അന്വേഷണങ്ങളിൽ നിന്നും എന്റിറ്റികളെ തിരിച്ചറിയാനും വർഗ്ഗീകരിക്കാനും ഇത് ഉപയോഗിക്കുന്നു. ഉദാഹരണത്തിന്, NER ന്റെ സഹായത്തോടെ, സെർച്ച് എഞ്ചിന് സന്ദർഭത്തെ അടിസ്ഥാനമാക്കി കമ്പനിയെ "ആപ്പിൾ" എന്നും പഴത്തെ "ആപ്പിൾ" എന്നും വേർതിരിച്ചറിയാൻ കഴിയും. കൃത്യവും സന്ദർഭ-അവബോധമുള്ളതുമായ ഫലങ്ങൾ നൽകുന്നതിന് NER പ്രക്രിയ നടപ്പിലാക്കുന്നത് നിർണായകമാണ്.
- ചാറ്റ്ബോട്ടുകൾ: ഉപയോക്തൃ അന്വേഷണങ്ങളിൽ നിന്നുള്ള പ്രധാന കാര്യങ്ങൾ മനസ്സിലാക്കാൻ ചാറ്റ്ബോട്ടുകൾക്കും AI അസിസ്റ്റന്റുകൾക്കും NER ഉപയോഗിക്കാൻ കഴിയും. അങ്ങനെ ചെയ്യുന്നതിലൂടെ, ചാറ്റ്ബോട്ടുകൾക്ക് കൂടുതൽ കൃത്യമായ പ്രതികരണങ്ങൾ നൽകാൻ കഴിയും. ഉദാഹരണത്തിന്, "സെൻട്രൽ പാർക്കിന് സമീപമുള്ള ഇറ്റാലിയൻ റെസ്റ്റോറന്റുകൾ കണ്ടെത്തുക" എന്ന് നിങ്ങൾ ചോദിച്ചാൽ, ചാറ്റ്ബോട്ടിന് "ഇറ്റാലിയൻ" എന്നത് പാചകരീതിയുടെ തരമായും, "റെസ്റ്റോറന്റുകൾ" എന്നത് സ്ഥലമായും, "സെൻട്രൽ പാർക്ക്" എന്നത് സ്ഥലമായും മനസ്സിലാകും. പ്രസക്തമായ വിവരങ്ങൾ കാര്യക്ഷമമായി വേർതിരിച്ചെടുക്കാൻ NER പ്രക്രിയ ഈ സിസ്റ്റങ്ങളെ പ്രാപ്തമാക്കുന്നു.
- ഇൻവെസ്റ്റിഗേറ്റീവ് ജേണലിസം: 11.5 ദശലക്ഷം സാമ്പത്തികവും നിയമപരവുമായ രേഖകളുടെ വൻ ചോർച്ചയുണ്ടായ പനാമ പേപ്പറുകൾ വിശകലനം ചെയ്യാൻ ഒരു പ്രശസ്ത മാധ്യമ സ്ഥാപനമായ ഇൻ്റർനാഷണൽ കൺസോർഷ്യം ഓഫ് ഇൻവെസ്റ്റിഗേറ്റീവ് ജേണലിസ്റ്റ്സ് (ഐസിഐജെ) NER ഉപയോഗിച്ചു. ഈ സാഹചര്യത്തിൽ, ദശലക്ഷക്കണക്കിന് ഘടനാരഹിതമായ രേഖകളിൽ ഉടനീളം ആളുകളെയും ഓർഗനൈസേഷനുകളും സ്ഥലങ്ങളും സ്വയമേവ തിരിച്ചറിയുന്നതിനും ഓഫ്ഷോർ നികുതി വെട്ടിപ്പിൻ്റെ മറഞ്ഞിരിക്കുന്ന നെറ്റ്വർക്കുകൾ കണ്ടെത്തുന്നതിനും NER ഉപയോഗിച്ചു.
- ബയോ ഇൻഫോർമാറ്റിക്സ്: ബയോഇൻഫോർമാറ്റിക്സ് മേഖലയിൽ, ബയോമെഡിക്കൽ ഗവേഷണ പ്രബന്ധങ്ങളിൽ നിന്നും ക്ലിനിക്കൽ ട്രയൽ റിപ്പോർട്ടുകളിൽ നിന്നും ജീനുകൾ, പ്രോട്ടീനുകൾ, മരുന്നുകൾ, രോഗങ്ങൾ തുടങ്ങിയ പ്രധാന ഘടകങ്ങളെ വേർതിരിച്ചെടുക്കാൻ NER ഉപയോഗിക്കുന്നു. അത്തരം ഡാറ്റ മരുന്ന് കണ്ടെത്തൽ പ്രക്രിയ വേഗത്തിലാക്കാൻ സഹായിക്കുന്നു. വലിയ ബയോമെഡിക്കൽ കോർപ്പറേഷനുകളെക്കുറിച്ചുള്ള മോഡലുകളുടെ പ്രീ-പരിശീലനം ഈ പ്രത്യേക ഡൊമെയ്നിലെ NER സിസ്റ്റങ്ങളുടെ പ്രകടനം ഗണ്യമായി മെച്ചപ്പെടുത്തും.
- സോഷ്യൽ മീഡിയ നിരീക്ഷണം: സോഷ്യൽ മീഡിയയിലെ ബ്രാൻഡുകൾ അവരുടെ പരസ്യ കാമ്പെയ്നുകളുടെ മൊത്തത്തിലുള്ള മെട്രിക്സും അവരുടെ എതിരാളികൾ എങ്ങനെ പ്രവർത്തിക്കുന്നു എന്നതും ട്രാക്ക് ചെയ്യാൻ NER ഉപയോഗിക്കുന്നു. ഉദാഹരണത്തിന്, അവരുടെ ബ്രാൻഡിനെ പരാമർശിക്കുന്ന ട്വീറ്റുകൾ വിശകലനം ചെയ്യാൻ NER ഉപയോഗിക്കുന്ന ഒരു എയർലൈൻ ഉണ്ട്. ഒരു പ്രത്യേക വിമാനത്താവളത്തിലെ "നഷ്ടപ്പെട്ട ലഗേജ്" പോലുള്ള സ്ഥാപനങ്ങളെക്കുറിച്ചുള്ള നെഗറ്റീവ് കമന്ററി ഇത് കണ്ടെത്തുന്നു, അതുവഴി അവർക്ക് കഴിയുന്നത്ര വേഗത്തിൽ പ്രശ്നം പരിഹരിക്കാൻ കഴിയും. വലിയ അളവിലുള്ള സോഷ്യൽ മീഡിയ ഡാറ്റയിൽ നിന്ന് പ്രവർത്തനക്ഷമമായ ഉൾക്കാഴ്ചകൾ വേർതിരിച്ചെടുക്കുന്നതിന് NER പ്രക്രിയ അത്യാവശ്യമാണ്.
- സന്ദർഭോചിതമായ പരസ്യംചെയ്യൽ: പരസ്യ പ്ലാറ്റ്ഫോമുകൾ വെബ് പേജുകളിൽ നിന്ന് പ്രധാന എന്റിറ്റികൾ വേർതിരിച്ചെടുക്കാൻ NER ഉപയോഗിക്കുന്നു, അങ്ങനെ ഉള്ളടക്കത്തിനൊപ്പം കൂടുതൽ പ്രസക്തമായ പരസ്യങ്ങൾ പ്രദർശിപ്പിക്കും, ഇത് ഒടുവിൽ പരസ്യ ടാർഗെറ്റിംഗും ക്ലിക്ക്-ത്രൂ നിരക്കുകളും മെച്ചപ്പെടുത്തുന്നു. ഉദാഹരണത്തിന്, ഒരു യാത്രാ ബ്ലോഗിൽ NER "ഹവായി", "ഹോട്ടലുകൾ", "ബീച്ചുകൾ" എന്നിവ കണ്ടെത്തിയാൽ, പരസ്യ പ്ലാറ്റ്ഫോം സാധാരണ ഹോട്ടൽ ശൃംഖലകളേക്കാൾ ഹവായിയൻ റിസോർട്ടുകൾക്കുള്ള ഡീലുകൾ കാണിക്കും.
- റിക്രൂട്ടിംഗ്, റെസ്യൂം സ്ക്രീനിംഗ്: അപേക്ഷകന്റെ വൈദഗ്ധ്യം, അനുഭവം, പശ്ചാത്തലം എന്നിവയെ അടിസ്ഥാനമാക്കി ആവശ്യമായ കൃത്യമായ വൈദഗ്ധ്യങ്ങളും യോഗ്യതകളും കണ്ടെത്താൻ നിങ്ങൾക്ക് NER-നോട് നിർദ്ദേശിക്കാൻ കഴിയും. ഉദാഹരണത്തിന്, ഒരു റിക്രൂട്ട്മെന്റ് ഏജൻസിക്ക് സ്ഥാനാർത്ഥികളെ സ്വയമേവ പൊരുത്തപ്പെടുത്താൻ NER ഉപയോഗിക്കാം. കമ്പനികൾക്ക് പ്രത്യേക ആവശ്യകതകൾക്ക് അനുസൃതമായി രൂപകൽപ്പന ചെയ്ത സ്വന്തം മോഡലുകൾ ഉപയോഗിക്കാം, അല്ലെങ്കിൽ അവരുടെ പേരുള്ള എന്റിറ്റി തിരിച്ചറിയൽ സംവിധാനത്തിന്റെ കൃത്യത വർദ്ധിപ്പിക്കുന്നതിന് മുൻകൂട്ടി പരിശീലനം ലഭിച്ച മോഡലുകൾ ഉപയോഗിക്കാം.
വ്യവസായങ്ങളിലുടനീളം നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ (NER) ന്റെ പ്രയോഗങ്ങൾ
നാച്ചുറൽ ലാംഗ്വേജ് പ്രോസസ്സിംഗ്, മെഷീൻ ലേണിംഗിനും ആഴത്തിലുള്ള പഠന പരിഹാരങ്ങൾക്കുമായി പരിശീലന ഡാറ്റാസെറ്റുകൾ സൃഷ്ടിക്കൽ എന്നിവയുമായി ബന്ധപ്പെട്ട നിരവധി മേഖലകളിൽ NER-ന് നിരവധി ഉപയോഗ കേസുകളുണ്ട്. വലിയ അളവിലുള്ള വാചകങ്ങളിൽ നിന്ന് എന്റിറ്റികളുടെ യാന്ത്രിക വേർതിരിച്ചെടുക്കൽ സാധ്യമാക്കുന്ന തരത്തിൽ പുതിയ ഡാറ്റയിൽ NER നടപ്പിലാക്കാൻ പരിശീലനം ലഭിച്ച ഒരു മാതൃക ഉപയോഗിക്കുന്നു. ചില ആപ്ലിക്കേഷനുകൾ ഇവയാണ്:
കസ്റ്റമർ സപ്പോർട്ട്
ഉൽപ്പന്ന പേരുകൾ, സവിശേഷതകൾ, ബ്രാഞ്ച് ലൊക്കേഷനുകൾ എന്നിവയും അതിലേറെയും പോലുള്ള നിർണായക വിവരങ്ങളെ അടിസ്ഥാനമാക്കി പ്രസക്തമായ ഉപഭോക്തൃ പരാതികളും അന്വേഷണങ്ങളും ഫീഡ്ബാക്കും ഒരു NER സിസ്റ്റത്തിന് എളുപ്പത്തിൽ കണ്ടെത്താൻ കഴിയും. പരാതി അല്ലെങ്കിൽ ഫീഡ്ബാക്ക് ഉചിതമായ രീതിയിൽ തരംതിരിക്കുകയും മുൻഗണനാ കീവേഡുകൾ ഫിൽട്ടർ ചെയ്യുന്നതിലൂടെ ശരിയായ വകുപ്പിലേക്ക് തിരിച്ചുവിടുകയും ചെയ്യുന്നു.
കാര്യക്ഷമമായ മനുഷ്യവിഭവശേഷി
ഹ്യൂമൻ റിസോഴ്സ് ടീമുകളെ അവരുടെ നിയമന പ്രക്രിയ മെച്ചപ്പെടുത്താനും അപേക്ഷകരുടെ ബയോഡാറ്റകൾ വേഗത്തിൽ സംഗ്രഹിച്ച് ടൈംലൈനുകൾ കുറയ്ക്കാനും NER സഹായിക്കുന്നു. NER ടൂളുകൾക്ക് റെസ്യൂമെ സ്കാൻ ചെയ്യാനും പ്രസക്തമായ വിവരങ്ങൾ എക്സ്ട്രാക്റ്റുചെയ്യാനും കഴിയും - പേര്, പ്രായം, വിലാസം, യോഗ്യത, കോളേജ് മുതലായവ.
കൂടാതെ, ജീവനക്കാരുടെ പരാതികൾ ഫിൽട്ടർ ചെയ്ത് ബന്ധപ്പെട്ട വകുപ്പ് മേധാവികൾക്ക് കൈമാറിക്കൊണ്ട് ആന്തരിക വർക്ക്ഫ്ലോകൾ കാര്യക്ഷമമാക്കാൻ എച്ച്ആർ ഡിപ്പാർട്ട്മെന്റിന് NER ടൂളുകളും ഉപയോഗിക്കാം.
ഉള്ളടക്ക വർഗ്ഗീകരണം
വാർത്താ ദാതാക്കളെ സംബന്ധിച്ചിടത്തോളം ഉള്ളടക്ക വർഗ്ഗീകരണം ഒരു വലിയ കടമയാണ്. വ്യത്യസ്ത വിഭാഗങ്ങളായി ഉള്ളടക്കത്തെ തരംതിരിക്കുന്നത് കണ്ടെത്താനും ഉൾക്കാഴ്ചകൾ നേടാനും ട്രെൻഡുകൾ തിരിച്ചറിയാനും വിഷയങ്ങൾ മനസ്സിലാക്കാനും എളുപ്പമാക്കുന്നു. ഒരു നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ ടൂൾ വാർത്താ ദാതാക്കൾക്ക് ഉപയോഗപ്രദമാകും. ഇതിന് നിരവധി ലേഖനങ്ങൾ സ്കാൻ ചെയ്യാനും മുൻഗണനാ കീവേഡുകൾ തിരിച്ചറിയാനും വ്യക്തികൾ, സ്ഥാപനം, സ്ഥലം എന്നിവയെ അടിസ്ഥാനമാക്കി വിവരങ്ങൾ വേർതിരിച്ചെടുക്കാനും കഴിയും.
സെർച്ച് എഞ്ചിനുകൾ ഒപ്റ്റിമൈസ് ചെയ്യുന്നു

കൃത്യമായ ഉള്ളടക്ക ശുപാർശ
ഒപ്റ്റിമൈസ് ചെയ്തതും ഇഷ്ടാനുസൃതമാക്കിയതുമായ ഉപഭോക്തൃ അനുഭവം നൽകുന്നതിന് നിരവധി ആധുനിക ആപ്ലിക്കേഷനുകൾ NER ടൂളുകളെ ആശ്രയിച്ചിരിക്കുന്നു. ഉദാഹരണത്തിന്, പേരുനൽകിയ എന്റിറ്റി തിരിച്ചറിയൽ ഉപയോഗിച്ച് ഉപയോക്താവിന്റെ തിരയൽ, കാഴ്ച ചരിത്രത്തെ അടിസ്ഥാനമാക്കിയുള്ള വ്യക്തിഗത ശുപാർശകൾ Netflix നൽകുന്നു.

നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ നിങ്ങളുടെ മെഷീൻ ലേണിംഗ് മോഡലുകളെ കൂടുതൽ കാര്യക്ഷമവും വിശ്വസനീയവുമാക്കുന്നു - എന്നാൽ ഗുണനിലവാരമുള്ളതും സ്ഥിരമായി ലേബൽ ചെയ്തതുമായ ഡാറ്റയിൽ പരിശീലനം നേടിയാൽ മാത്രമേ അവ മികച്ച പ്രകടനം കാഴ്ചവയ്ക്കൂ. അവിടെയാണ് പരിചയസമ്പന്നനായ ഒരു പങ്കാളിയുടെ പ്രാധാന്യം: Shaip-ന്റെ NER ഡാറ്റ അനോട്ടേഷൻ സേവനങ്ങൾ ധനകാര്യം, ഇൻഷുറൻസ്, ആരോഗ്യ സംരക്ഷണം തുടങ്ങിയ ഡൊമെയ്നുകളിലുടനീളം സമഗ്രവും ഉപയോഗിക്കാൻ തയ്യാറായതുമായ NER ഡാറ്റാസെറ്റുകൾ നൽകുന്നു, അതിനാൽ നിങ്ങൾക്ക് കാര്യക്ഷമവും നൂതനവുമായ ML മോഡലുകൾ വേഗത്തിൽ വികസിപ്പിക്കാൻ കഴിയും.
[ഇതും വായിക്കുക: NLP എന്താണ്? ഇത് എങ്ങനെ പ്രവർത്തിക്കുന്നു, നേട്ടങ്ങൾ, വെല്ലുവിളികൾ, ഉദാഹരണങ്ങൾ
ഒരു NER മോഡലിനെ എങ്ങനെയാണ് വിലയിരുത്തുന്നത്?
NER മോഡലുകൾ മൂന്ന് മെട്രിക്സുകൾ ഉപയോഗിച്ചാണ് സ്കോർ ചെയ്യുന്നത്: പ്രിസിഷൻ, റീകോൾ, F1-സ്കോർ. അവർ മോഡലിന്റെ പ്രവചനങ്ങളെ ശരിയായി ലേബൽ ചെയ്ത എന്റിറ്റികളുടെ "ഗ്രൗണ്ട് ട്രൂത്ത്" സെറ്റുമായി താരതമ്യം ചെയ്യുന്നു.
- കൃതത: മോഡൽ പ്രവചിച്ച എന്റിറ്റികളിൽ എത്രയെണ്ണം ശരിയായിരുന്നു? ഇത് തെറ്റായ പോസിറ്റീവുകൾ അളക്കുന്നു.
- ഓർമ്മിക്കുക: യഥാർത്ഥത്തിൽ നിലവിലുള്ള എന്റിറ്റികളിൽ, എത്രയെണ്ണം മോഡൽ കണ്ടെത്തി? ഇത് തെറ്റായ നെഗറ്റീവുകൾ അളക്കുന്നു.
- F1-സ്കോർ: കൃത്യതയുടെയും ഓർമ്മയുടെയും ഹാർമോണിക് ശരാശരി - രണ്ടും സന്തുലിതമാക്കുന്ന ഒരു സംഖ്യ.
ഉപയോഗിച്ച ഉദാഹരണം : “ആപ്പിൾ ഇൻകോർപ്പറേറ്റഡ് 2026 മാർച്ചിൽ സാൻ ഫ്രാൻസിസ്കോയിൽ ഒരു ഓഫീസ് തുറക്കുന്നു” എന്നതിൽ, മോഡൽ “ആപ്പിൾ ഇൻകോർപ്പറേറ്റഡ്” എന്നും “സാൻ ഫ്രാൻസിസ്കോ” എന്നും ശരിയായി ടാഗ് ചെയ്തിട്ടുണ്ടെങ്കിൽ, “ഓഫീസ്” ഒരു ലൊക്കേഷനായി തെറ്റായി ടാഗ് ചെയ്തിട്ടുണ്ടെങ്കിൽ, “മാർച്ച് 2026” എന്ന് നഷ്ടപ്പെട്ടാൽ. അത് 2 യഥാർത്ഥ പോസിറ്റീവുകളും 1 തെറ്റായ പോസിറ്റീവും 1 തെറ്റായ നെഗറ്റീവും നൽകുന്നു. കൃത്യത = 2/3 ≈ 0.67, തിരിച്ചുവിളിക്കൽ = 2/3 ≈ 0.67, F1-സ്കോർ ≈ 0.67. മോഡൽ പരിശീലനത്തിൽ ഒരിക്കലും കണ്ടിട്ടില്ലാത്ത ഡാറ്റ - ഒരു ഹോൾഡ്-ഔട്ട് വാലിഡേഷൻ സെറ്റിൽ പരിശോധന നടത്തേണ്ടത് അത്യാവശ്യമാണ്, അത് ഓർമ്മിക്കുന്നതിനേക്കാൾ സാമാന്യവൽക്കരിക്കുന്നത് സ്ഥിരീകരിക്കുന്നതിന് അത്യാവശ്യമാണ്.
NER ടൂളുകളും ലൈബ്രറികളും താരതമ്യം:
നിരവധി ശക്തമായ ഉപകരണങ്ങളും ലൈബ്രറികളും NER നടപ്പിലാക്കൽ സുഗമമാക്കുന്നു. ചില ജനപ്രിയ ഓപ്ഷനുകളുടെ താരതമ്യം ഇതാ:
| ഉപകരണം/ലൈബ്രറി | വിവരണം | ശക്തി | ദുർബലത |
|---|---|---|---|
| സ്പേസി | പൈത്തണിലെ വേഗതയേറിയതും കാര്യക്ഷമവുമായ NLP ലൈബ്രറി. | മികച്ച പ്രകടനം, ഉപയോഗിക്കാൻ എളുപ്പമാണ്, മുൻകൂട്ടി പരിശീലിപ്പിച്ച മോഡലുകൾ ലഭ്യമാണ്. | ഇംഗ്ലീഷ് ഒഴികെയുള്ള ഭാഷകൾക്ക് പരിമിതമായ പിന്തുണ. |
| എൻ.എൽ.ടി.കെ | പൈത്തണിലെ സമഗ്രമായ NLP ലൈബ്രറി. | പ്രവർത്തനങ്ങളുടെ വിപുലമായ ശ്രേണി, വിദ്യാഭ്യാസ ആവശ്യങ്ങൾക്ക് നല്ലതാണ്. | സ്പാസിയെക്കാൾ വേഗത കുറവായിരിക്കാം. |
| സ്റ്റാൻഫോർഡ് കോർഎൻഎൽപി | ഒരു ജാവ അടിസ്ഥാനമാക്കിയുള്ള NLP ടൂൾകിറ്റ്. | വളരെ കൃത്യത, ഒന്നിലധികം ഭാഷകളെ പിന്തുണയ്ക്കുന്നു. | കൂടുതൽ കമ്പ്യൂട്ടേഷണൽ ഉറവിടങ്ങൾ ആവശ്യമാണ്. |
| ഓപ്പൺഎൻഎൽപി | NLP-ക്കായുള്ള ഒരു മെഷീൻ ലേണിംഗ് അധിഷ്ഠിത ടൂൾകിറ്റ്. | ഇഷ്ടാനുസൃതമാക്കാവുന്ന, ഒന്നിലധികം ഭാഷകളെ പിന്തുണയ്ക്കുന്നു. | സജ്ജീകരിക്കാൻ സങ്കീർണ്ണമായേക്കാം. |
NER-ൽ മാതൃകാ പരിശീലനം
ഫലപ്രദമായ നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷൻ (NER) സംവിധാനങ്ങൾ നിർമ്മിക്കുന്നതിന്റെ കാതലാണ് മോഡൽ പരിശീലനം. ലേബൽ ചെയ്ത പരിശീലന ഡാറ്റയിൽ നിന്ന് പഠിച്ചുകൊണ്ട്, ആളുകൾ, സ്ഥാപനങ്ങൾ, സ്ഥലങ്ങൾ തുടങ്ങിയ പേരുള്ള എന്റിറ്റികളെ തിരിച്ചറിയാനും തരംതിരിക്കാനും ഒരു മോഡലിനെ പഠിപ്പിക്കുന്നത് ഈ പ്രക്രിയയിൽ ഉൾപ്പെടുന്നു. എന്റിറ്റി റെക്കഗ്നിഷന്റെ വിജയം ഈ പരിശീലന ഡാറ്റയുടെ ഗുണനിലവാരത്തെയും വൈവിധ്യത്തെയും അതുപോലെ ഓരോ എന്റിറ്റി തരത്തിനും മുൻകൂട്ടി നിശ്ചയിച്ച വിഭാഗങ്ങളുടെ വ്യക്തതയെയും ആശ്രയിച്ചിരിക്കുന്നു.
മോഡൽ പരിശീലന സമയത്ത്, മെഷീൻ ലേണിംഗ് അൽഗോരിതങ്ങൾ ശരിയായ എന്റിറ്റി ലേബലുകൾ ഉപയോഗിച്ച് വ്യാഖ്യാനിച്ചിരിക്കുന്ന ടെക്സ്റ്റ് ഡാറ്റ വിശകലനം ചെയ്യുന്നു. റിക്കറന്റ് ന്യൂറൽ നെറ്റ്വർക്കുകൾ (RNN-കൾ), കൺവല്യൂഷണൽ ന്യൂറൽ നെറ്റ്വർക്കുകൾ (CNN-കൾ) ഉൾപ്പെടെയുള്ള ഡീപ് ലേണിംഗ് മോഡലുകൾ NER ടാസ്ക്കുകൾക്ക് പ്രത്യേകിച്ചും ജനപ്രിയമായി. ടെക്സ്റ്റിനുള്ളിലെ സങ്കീർണ്ണമായ പാറ്റേണുകളും ബന്ധങ്ങളും പകർത്തുന്നതിൽ ഈ ന്യൂറൽ നെറ്റ്വർക്കുകൾ മികവ് പുലർത്തുന്നു, ഭാഷയിൽ സൂക്ഷ്മമായ വ്യതിയാനങ്ങൾ നേരിടുമ്പോൾ പോലും ശ്രദ്ധേയമായ കൃത്യതയോടെ എന്റിറ്റികളെ തിരിച്ചറിയാൻ NER മോഡലിനെ പ്രാപ്തമാക്കുന്നു.
എന്നിരുന്നാലും, നാമകരണം ചെയ്ത എന്റിറ്റി റെക്കഗ്നിഷൻ നേഴ്സിനായി ആഴത്തിലുള്ള പഠന മോഡലുകൾ പരിശീലിപ്പിക്കുന്നതിന് വലിയ അളവിലുള്ള ലേബൽ ചെയ്ത ഡാറ്റ ആവശ്യമാണ്, ഇത് നിർമ്മിക്കാൻ സമയമെടുക്കുന്നതും ചെലവേറിയതുമാണ്. ഇത് പരിഹരിക്കുന്നതിന്, ഡാറ്റ ഓഗ്മെന്റേഷൻ, ട്രാൻസ്ഫർ ലേണിംഗ് പോലുള്ള സാങ്കേതിക വിദ്യകൾ പലപ്പോഴും ഉപയോഗിക്കുന്നു. നിലവിലുള്ള ഡാറ്റയിൽ നിന്ന് പുതിയ ഉദാഹരണങ്ങൾ സൃഷ്ടിച്ചുകൊണ്ട് ഡാറ്റ ഓഗ്മെന്റേഷൻ പരിശീലന ഡാറ്റാസെറ്റ് വികസിപ്പിക്കുന്നു, അതേസമയം ട്രാൻസ്ഫർ ലേണിംഗ് ഇതിനകം തന്നെ പൊതുവായ ഭാഷാ പാറ്റേണുകൾ പഠിച്ചിട്ടുള്ള പ്രീ-ട്രെയിൻഡ് മോഡലുകളെ സ്വാധീനിക്കുന്നു, ഡൊമെയ്ൻ-നിർദ്ദിഷ്ട ഡാറ്റയിൽ ഫൈൻ-ട്യൂണിംഗ് മാത്രം ആവശ്യമാണ്.
ആത്യന്തികമായി, ഒരു NER മോഡലിന്റെ ഫലപ്രാപ്തി ശക്തമായ മോഡൽ പരിശീലനം, ഉയർന്ന നിലവാരമുള്ള ലേബൽ ചെയ്ത ഡാറ്റ, നിർദ്ദിഷ്ട എന്റിറ്റി തിരിച്ചറിയൽ ചുമതലയ്ക്ക് അനുയോജ്യമായ മെഷീൻ ലേണിംഗ് അല്ലെങ്കിൽ ആഴത്തിലുള്ള പഠന മോഡലുകളുടെ ശ്രദ്ധാപൂർവ്വമായ തിരഞ്ഞെടുപ്പ് എന്നിവയെ ആശ്രയിച്ചിരിക്കുന്നു.
ഫലപ്രദമായ NER-നുള്ള മികച്ച രീതികൾ
നെയിംഡ് എന്റിറ്റി റെക്കഗ്നിഷനിൽ (NER) ഉയർന്ന പ്രകടനം കൈവരിക്കുന്നതിന് ഡാറ്റ ഗുണനിലവാരവും മോഡൽ വികസനവും അഭിസംബോധന ചെയ്യുന്ന ഒരു കൂട്ടം മികച്ച രീതികൾ പിന്തുടരേണ്ടതുണ്ട്. ഫലപ്രദമായ എന്റിറ്റി റെക്കഗ്നിഷനുള്ള ചില പ്രധാന തന്ത്രങ്ങൾ ഇതാ:
- ഉയർന്ന നിലവാരമുള്ള പരിശീലന ഡാറ്റയ്ക്ക് മുൻഗണന നൽകുക: ഏതൊരു വിജയകരമായ NER മോഡലിന്റെയും അടിസ്ഥാനം വൈവിധ്യമാർന്നതും, നന്നായി വ്യാഖ്യാനിച്ചതും, പ്രതിനിധീകരിക്കുന്നതുമായ പരിശീലന ഡാറ്റയാണ്. പുതിയ സാഹചര്യങ്ങളിലേക്ക് മോഡലിന് സാമാന്യവൽക്കരിക്കാൻ കഴിയുമെന്ന് ഉറപ്പാക്കാൻ ലേബൽ ചെയ്ത ഡാറ്റ വിവിധ എന്റിറ്റി തരങ്ങളെയും സന്ദർഭങ്ങളെയും ഉൾക്കൊള്ളണം.
- സമഗ്രമായ ടെക്സ്റ്റ് പ്രീപ്രോസസ്സിംഗ്: ടോക്കണൈസേഷൻ, പാർട്ട്-ഓഫ്-സ്പീച്ച് ടാഗിംഗ് പോലുള്ള ഘട്ടങ്ങൾ മോഡലിനെ ടെക്സ്റ്റിന്റെ ഘടന നന്നായി മനസ്സിലാക്കാൻ സഹായിക്കുന്നു, പേരുള്ള എന്റിറ്റികളെ കൃത്യമായി തിരിച്ചറിയാനും തരംതിരിക്കാനുമുള്ള കഴിവ് മെച്ചപ്പെടുത്തുന്നു.
- ശരിയായ അൽഗോരിതങ്ങൾ തിരഞ്ഞെടുക്കുക: ലളിതമായതോ വളരെ ഘടനാപരമായതോ ആയ ജോലികൾക്ക് നിയമാധിഷ്ഠിത രീതികൾ ഫലപ്രദമാകുമെങ്കിലും, RNN-കൾ, CNN-കൾ പോലുള്ള ആഴത്തിലുള്ള പഠന മാതൃകകൾ പലപ്പോഴും സങ്കീർണ്ണവും വലുതുമായ NER ജോലികൾക്ക് മികച്ച ഫലങ്ങൾ നൽകുന്നു.
- മുൻകൂട്ടി പരിശീലിപ്പിച്ച മോഡലുകൾ പ്രയോജനപ്പെടുത്തുക: മുൻകൂട്ടി പരിശീലനം ലഭിച്ച മോഡലുകൾ ഉപയോഗിക്കുകയും നിങ്ങളുടെ നിർദ്ദിഷ്ട ഡാറ്റാസെറ്റിൽ അവയെ ഫൈൻ-ട്യൂൺ ചെയ്യുകയും ചെയ്യുന്നത് വലിയ ലേബൽ ചെയ്ത ഡാറ്റാസെറ്റുകളുടെ ആവശ്യകത ഗണ്യമായി കുറയ്ക്കുകയും വികസനം വേഗത്തിലാക്കുകയും പ്രകടനം മെച്ചപ്പെടുത്തുകയും ചെയ്യും.
- തുടർച്ചയായ മോഡൽ വിലയിരുത്തലും ഫൈൻ-ട്യൂണിംഗും: ശക്തമായ മൂല്യനിർണ്ണയ അളവുകൾ ഉപയോഗിച്ച് നിങ്ങളുടെ നേർ മോഡലിന്റെ പ്രകടനം പതിവായി വിലയിരുത്തുക, പുതിയ ഡാറ്റയോ എന്റിറ്റി തിരിച്ചറിയൽ ജോലികളോ ഉയർന്നുവരുമ്പോൾ അത് അപ്ഡേറ്റ് ചെയ്യുക.
- സന്ദർഭോചിതമായ അവബോധം: എന്റിറ്റികൾ പ്രത്യക്ഷപ്പെടുന്ന സന്ദർഭം എപ്പോഴും പരിഗണിക്കുക. ഒന്നിലധികം അർത്ഥങ്ങളുള്ളേക്കാവുന്ന എന്റിറ്റി നാമങ്ങളെ അവ്യക്തമാക്കാൻ ഇത് സഹായിക്കുന്നു, ഇത് കൂടുതൽ കൃത്യമായ എന്റിറ്റി തിരിച്ചറിയലിലേക്ക് നയിക്കുന്നു.
ഈ മികച്ച രീതികൾ പാലിക്കുന്നതിലൂടെ, സങ്കീർണ്ണമായ ടെക്സ്റ്റ് ഡാറ്റയിൽ നിന്ന് എന്റിറ്റികൾ വേർതിരിച്ചെടുക്കുന്നതിൽ മികവ് പുലർത്തുന്ന കൂടുതൽ കൃത്യവും, പൊരുത്തപ്പെടുത്താവുന്നതും, കാര്യക്ഷമവുമായ NER സിസ്റ്റങ്ങൾ നിർമ്മിക്കാൻ സ്ഥാപനങ്ങൾക്ക് കഴിയും.
കേസ് പഠനം: ഓങ്കോളജി ഗവേഷണത്തിനായുള്ള ക്ലിനിക്കൽ NER
ക്ലിനിക്കൽ ടെക്സ്റ്റ് എന്നത് NER ശരിക്കും ബുദ്ധിമുട്ടാകുന്ന ഇടമാണ് - അത് ഏറ്റവും പ്രധാനപ്പെട്ട ഇടവുമാണ്. ഒരു ആരോഗ്യ സംരക്ഷണ പദ്ധതിയിൽ, ഒരു പ്രധാന ആരോഗ്യ സംരക്ഷണ സ്ഥാപനത്തെ ഘടനാരഹിതമായ ഓങ്കോളജി റെക്കോർഡുകൾ ഗവേഷണത്തിന് തയ്യാറായ ഡാറ്റാസെറ്റാക്കി മാറ്റാൻ സഹായിക്കുന്നതിന് ഷൈപ് ഒരു ക്ലിനിക്കൽ NER-ഉം ഡീ-ഐഡന്റിഫിക്കേഷൻ പൈപ്പ്ലൈനും നിർമ്മിച്ചു, എല്ലാം HIPAA പ്രകാരം.
വ്യക്തിയെയും സ്ഥലത്തെയും ടാഗ് ചെയ്യുന്നതിനപ്പുറം ഈ പ്രവർത്തനം വളരെയധികം മുന്നോട്ട് പോയി. ഓങ്കോളജി വൈദഗ്ധ്യമുള്ള വ്യാഖ്യാന ടീമുകൾ ഏകദേശം 10,000 പേജുകളുള്ള ഓങ്കോളജി റെക്കോർഡുകളിൽ ഒരു സമ്പന്നമായ എന്റിറ്റി സ്കീമ ലേബൽ ചെയ്തു, അവയിൽ ഇവ ഉൾപ്പെടുന്നു:
- രോഗ ഘടകങ്ങൾ: കാൻസർ പ്രശ്നം, ഹിസ്റ്റോളജി, ശരീര സ്ഥാനം, പെരുമാറ്റം, ഗ്രേഡ്, കാൻസർ ഘട്ടം, TNM ഘട്ടം.
- ചികിത്സാ സ്ഥാപനങ്ങൾ: കാൻസർ മരുന്ന്, മരുന്നിന്റെ അളവ്, ആവൃത്തി, കാൻസർ ശസ്ത്രക്രിയ, റേഡിയേഷൻ രീതി, അളവ് എന്നിവ.
- ജീനോമിക്സ് എന്റിറ്റികൾ: പഠിച്ച ജീൻ, വേരിയേഷൻ കോഡ്, രീതി, മാതൃക.
- നിഷേധ നില: നെഗറ്റീവ്, സാധ്യമായ-നെഗറ്റീവ്, അനിശ്ചിതത്വം, സാധ്യമായ-പോസിറ്റീവ് കണ്ടെത്തലുകൾ എന്നിവ വേർതിരിച്ചറിയൽ - ക്ലിനിക്കൽ കുറിപ്പുകളിൽ നിർണായകം.
- ക്ലിനിക്കൽ NER ബന്ധങ്ങൾ: കാൻസർ പ്രശ്നം → ശരീര സൈറ്റ്, ഹിസ്റ്റോളജി → ഗ്രേഡ് പോലുള്ള ലിങ്കിംഗ് എന്റിറ്റികൾ, അതിനാൽ ഡാറ്റ ലേബലുകൾ മാത്രമല്ല, അർത്ഥവും പിടിച്ചെടുക്കുന്നു.
ഷൈപ്പിന്റെ 5 ദശലക്ഷത്തിലധികം ഇലക്ട്രോണിക് ഹെൽത്ത് റെക്കോർഡുകളുടെ ശേഖരത്തിൽ നിന്നാണ് ഡാറ്റാസെറ്റ് ക്യൂറേറ്റ് ചെയ്തത്, പിന്നീട് HIPAA യുടെ സേഫ് ഹാർബർ രീതി ഉപയോഗിച്ച് അത് ഡി-ഐഡന്റിറ്റി ചെയ്തു - സംരക്ഷിത ആരോഗ്യ വിവരങ്ങളുടെ ഓരോ ഭാഗവും ലേബൽ ചെയ്ത പ്ലെയ്സ്ഹോൾഡറുകൾ ഉപയോഗിച്ച് മാറ്റിസ്ഥാപിച്ചു, അങ്ങനെ രോഗിയുടെ സ്വകാര്യത കേടുകൂടാതെയിരിക്കുമ്പോൾ ഡാറ്റ ഉപയോഗപ്രദമായി തുടർന്നു. തുടർച്ചയായ QA റൗണ്ടുകളും ക്ലയന്റ് ഫീഡ്ബാക്കും അനോട്ടേഷനുകളെ ആവശ്യമായ ഗുണനിലവാര മാനദണ്ഡത്തിലേക്ക് നിലനിർത്തി.
ഫലം: ക്ലയന്റിന്റെ ഓങ്കോളജി NLP മോഡൽ വികസനത്തിന് ഇപ്പോൾ അടിത്തറയിടുന്ന 10,000 ഉയർന്ന നിലവാരമുള്ള, തിരിച്ചറിയൽ നീക്കം ചെയ്ത, ലേബൽ ചെയ്ത റെക്കോർഡുകൾ. പ്രൊഡക്ഷൻ ക്ലിനിക്കൽ NER എന്താണ് ആവശ്യപ്പെടുന്നതെന്ന് പ്രോജക്റ്റ് കാണിക്കുന്നു - ഡൊമെയ്ൻ-വിദഗ്ധ വ്യാഖ്യാനകർ, ബന്ധങ്ങളെക്കുറിച്ചുള്ള അവബോധമുള്ള സ്കീമ, നിഷേധാത്മക കൈകാര്യം ചെയ്യൽ, എയർടൈറ്റ് കംപ്ലയൻസ് - ഇവയൊന്നും ഒരു പൊതു-ഉദ്ദേശ്യ മോഡൽ ബോക്സിന് പുറത്ത് നൽകുന്നില്ല. പൂർണ്ണമായ തകർച്ചയ്ക്കായി നിങ്ങൾക്ക് പൂർണ്ണ ഓങ്കോളജി NLP വികസന കേസ് സ്റ്റഡി വായിക്കാം.
NER ആനുകൂല്യങ്ങളും വെല്ലുവിളികളും?
ആനുകൂല്യങ്ങൾ:
- വിവരങ്ങൾ വേർതിരിച്ചെടുക്കൽ: NER പ്രധാന ഡാറ്റയെ തിരിച്ചറിയുന്നു, വിവരങ്ങൾ വീണ്ടെടുക്കാൻ സഹായിക്കുന്നു.
- ഉള്ളടക്ക ഓർഗനൈസേഷൻ: ഡാറ്റാബേസുകൾക്കും സെർച്ച് എഞ്ചിനുകൾക്കും ഉപയോഗപ്രദമായ ഉള്ളടക്കം തരംതിരിക്കാൻ ഇത് സഹായിക്കുന്നു.
- മെച്ചപ്പെടുത്തിയ ഉപയോക്തൃ അനുഭവം: NER തിരയൽ ഫലങ്ങൾ പരിഷ്കരിക്കുകയും ശുപാർശകൾ വ്യക്തിഗതമാക്കുകയും ചെയ്യുന്നു.
- ഉൾക്കാഴ്ചയുള്ള വിശകലനം: ഇത് വികാര വിശകലനവും പ്രവണത കണ്ടെത്തലും സുഗമമാക്കുന്നു.
- യാന്ത്രിക വർക്ക്ഫ്ലോ: NER ഓട്ടോമേഷൻ പ്രോത്സാഹിപ്പിക്കുന്നു, സമയവും വിഭവങ്ങളും ലാഭിക്കുന്നു.
പരിമിതികൾ / വെല്ലുവിളികൾ:
- അവ്യക്തത പ്രമേയം: "ആമസോൺ" പോലെയുള്ള സമാന സ്ഥാപനങ്ങളെ ഒരു നദിയോ കമ്പനിയോ ആയി വേർതിരിച്ചറിയാൻ പോരാടുന്നു.
- ഡൊമെയ്ൻ-നിർദ്ദിഷ്ട അഡാപ്റ്റേഷൻ: വൈവിധ്യമാർന്ന ഡൊമെയ്നുകളിലുടനീളം റിസോഴ്സ്-ഇന്റൻസീവ്.
- ഭാഷാ വ്യതിയാനങ്ങൾ: സ്ലാംഗ്, പ്രാദേശിക വ്യത്യാസങ്ങൾ കാരണം ഫലപ്രാപ്തി വ്യത്യാസപ്പെടുന്നു.
- ലേബൽ ചെയ്ത ഡാറ്റയുടെ ദൗർലഭ്യം: പരിശീലനത്തിനായി ലേബൽ ചെയ്ത വലിയ ഡാറ്റാസെറ്റുകൾ ആവശ്യമാണ്.
- ഘടനയില്ലാത്ത ഡാറ്റ കൈകാര്യം ചെയ്യുന്നു: നൂതന സാങ്കേതിക വിദ്യകൾ ആവശ്യമാണ്.
- നിർവഹണ അളവ്: കൃത്യമായ വിലയിരുത്തൽ സങ്കീർണ്ണമാണ്.
- തത്സമയ പ്രോസസ്സിംഗ്: കൃത്യതയോടെ വേഗത ബാലൻസ് ചെയ്യുന്നത് വെല്ലുവിളിയാണ്.
- സന്ദർഭ ആശ്രിതത്വം: ചുറ്റുപാടുമുള്ള ടെക്സ്റ്റ് സൂക്ഷ്മതകൾ മനസ്സിലാക്കുന്നതിലാണ് കൃത്യത ആശ്രയിക്കുന്നത്.
- ഡാറ്റ സ്പാർസിറ്റി: കാര്യമായ ലേബൽ ചെയ്ത ഡാറ്റാസെറ്റുകൾ ആവശ്യമാണ്, പ്രത്യേകിച്ച് നിച്ച് ഏരിയകൾക്ക്.
പേരുള്ള എന്റിറ്റി തിരിച്ചറിയലിന്റെ ഭാവി എന്തായിരിക്കും?
NER-ന്റെ ഭാവി ലളിതമായ ഒരു ടാഗിംഗിനപ്പുറം സമ്പന്നവും കൂടുതൽ കാര്യക്ഷമവും കൂടുതൽ ബഹുഭാഷാ സംവിധാനങ്ങളിലേക്കും നീങ്ങുകയാണ്. നിരവധി മാറ്റങ്ങൾ വേറിട്ടുനിൽക്കുന്നു:
- കുറച്ച് ഷോട്ടും പൂജ്യം ഷോട്ടും ലേണിംഗ് വലിയ ലേബൽ ചെയ്ത ഡാറ്റാസെറ്റുകളെ ആശ്രയിക്കുന്നത് കുറയ്ക്കുന്നു, ഇത് NER നെ പുതിയ ഡൊമെയ്നുകളിലേക്ക് വ്യാപിപ്പിക്കുന്നത് വേഗത്തിലാക്കുന്നു.
- എൻ്റിറ്റി ലിങ്കിംഗ് — കണ്ടെത്തിയ ഒരു എന്റിറ്റിയെ ഒരു നോളജ്-ഗ്രാഫ് റെക്കോർഡിലേക്ക് ബന്ധിപ്പിക്കുന്നത് — ഒരു ലേബലറിൽ നിന്ന് NER-നെ ഒരു യുക്തിസഹമായ ഘട്ടമാക്കി മാറ്റുന്നു, വീണ്ടെടുക്കൽ-വർദ്ധിപ്പിച്ച ജനറേഷനുള്ള (RAG) ഒരു ഗ്രൗണ്ടിംഗ് ലെയറായി ഇത് ഉൾപ്പെടുന്നു.
- ട്രാൻസ്ഫോർമറും എൽഎൽഎം അടിസ്ഥാനമാക്കിയുള്ള എൻഇആർ അവ്യക്തവും നെസ്റ്റഡ് എന്റിറ്റികളുമായ കാര്യങ്ങളിൽ കൃത്യത വർദ്ധിപ്പിക്കുന്നത് തുടരുക.
- ബഹുഭാഷാ, പരസ്പരവിരുദ്ധ NER ബിസിനസുകൾ ആഗോളവൽക്കരിക്കപ്പെടുന്നതിനനുസരിച്ച് വികസിച്ചുകൊണ്ടിരിക്കുന്നു, കൂടാതെ ലിപികളിലും ഭാഷകളിലും സ്ഥിരമായ വേർതിരിച്ചെടുക്കൽ ആവശ്യമാണ്.
- ഇഷ്ടാനുസൃത, ഡൊമെയ്ൻ-നിർദ്ദിഷ്ട മോഡലുകൾ വൈദ്യശാസ്ത്രം, നിയമം, ധനകാര്യം എന്നിവ മാനദണ്ഡമായി മാറിക്കൊണ്ടിരിക്കുന്നു, കാരണം പ്രത്യേക സ്ഥാപനങ്ങൾ പൊതു കോർപ്പറയിൽ വളരെ അപൂർവമായി മാത്രമേ പ്രത്യക്ഷപ്പെടുന്നുള്ളൂ.
നിങ്ങളുടെ NER പ്രോജക്റ്റിന് Shaip തിരഞ്ഞെടുക്കുന്നത് എന്തുകൊണ്ട്?
മിക്ക NER പ്രോജക്ടുകളും മോഡലിനെ ആശ്രയിച്ചല്ല, മറിച്ച് ഡാറ്റയെ ആശ്രയിച്ചാണ് മുന്നോട്ട് പോകുന്നത്. NER വർക്കിനായി Shaip ശുപാർശ ചെയ്യുന്നത്, മുൻകൂട്ടി പരിശീലിപ്പിച്ച മോഡലുകൾക്ക് നൽകാൻ കഴിയാത്ത ഒരു ഘടകം മാത്രമാണ് ഞങ്ങൾ നൽകുന്നത്: കൃത്യമായ, ഡൊമെയ്ൻ-നിർദ്ദിഷ്ട, സ്ഥിരമായി ലേബൽ ചെയ്ത പരിശീലന ഡാറ്റ സ്കെയിലിൽ. NER, എന്റിറ്റി-എക്സ്ട്രാക്ഷൻ സംരംഭങ്ങൾക്കായി, ഞങ്ങൾ നൽകുന്നത്:
- ഡൊമെയ്ൻ-വിദഗ്ധ വ്യാഖ്യാനകർ — മെഡിക്കൽ, ലീഗൽ, ഫിനാൻഷ്യൽ, ക്ലിനിക്കൽ NER എന്നിവയ്ക്കായുള്ള പ്രത്യേക ടീമുകൾ ഉൾപ്പെടെ, ജനറിക് ലേബലുകൾ കുറവായിരിക്കും.
- ബന്ധവും നിഷേധ ലേബലിംഗും, വെറും ഫ്ലാറ്റ് എന്റിറ്റി ടാഗുകൾ അല്ല, അതിനാൽ നിങ്ങളുടെ മോഡൽ അർത്ഥവും സന്ദർഭവും പഠിക്കുന്നു.
- HIPAA, GDPR, SOC 2 എന്നിവPHI, PII പോലുള്ള സെൻസിറ്റീവ് ഡാറ്റയുടെ തിരിച്ചറിയൽ ഇല്ലാതാക്കി, -അലൈൻ ചെയ്ത വർക്ക്ഫ്ലോകൾ.
- മൾട്ടി-സ്റ്റേജ് ക്യുഎ ഓരോ ഡാറ്റാസെറ്റും നിങ്ങളുടെ ഗുണനിലവാര മാനദണ്ഡത്തിൽ നിലനിർത്തുന്നതിനായി പ്രോസസ്സ് വിദഗ്ധർ നിർമ്മിച്ചത്.
- ഫ്ലെക്സിബിൾ സ്കെയിൽ, ആഗോളതലത്തിൽ ഒരു തൊഴിൽ ശക്തിയെയും വലിയ സ്വകാര്യ ഡാറ്റാ ശേഖരണങ്ങളെയും ഉപയോഗപ്പെടുത്തി.
നിങ്ങൾക്ക് ഒരു ഇച്ഛാനുസൃത NER ഡാറ്റാസെറ്റ് ആവശ്യമുണ്ടെങ്കിലും, ക്ലിനിക്കൽ ഡി-ഐഡന്റിഫിക്കേഷൻ ആവശ്യമുണ്ടെങ്കിലും, അല്ലെങ്കിൽ എൻഡ്-ടു-എൻഡ് നാമകരണം ചെയ്ത എന്റിറ്റി റെക്കഗ്നിഷൻ അനോട്ടേഷൻ ആവശ്യമുണ്ടെങ്കിലും , ഞങ്ങളുടെ ടീമുകൾക്ക് അത് നിങ്ങളുടെ സ്കീമയിലേക്ക് നിർമ്മിക്കാൻ കഴിയും.
വിശ്വസിക്കാവുന്ന NER പരിശീലന ഡാറ്റ നിർമ്മിക്കാൻ തയ്യാറാണോ? നിങ്ങളുടെ പ്രോജക്റ്റ് സ്കോപ്പ് ചെയ്യുന്നതിനും നിങ്ങളുടെ AI/ML മോഡലുകൾക്കായി ഒരു ഇച്ഛാനുസൃത NER ഡാറ്റാസെറ്റ് നേടുന്നതിനും Shaip-നെ ബന്ധപ്പെടുക .
NER പതിവ് ചോദ്യങ്ങൾ: ഒരു പ്രോജക്റ്റ് ആരംഭിക്കുന്നതിന് മുമ്പ് ടീമുകൾ ചോദിക്കുന്ന ചോദ്യങ്ങൾ
"എന്താണ് NER" എന്നതിൽ നിന്ന് ഒരു NER പ്രോജക്റ്റ് യഥാർത്ഥത്തിൽ സ്കോപ്പിംഗ്, ബജറ്റിംഗ്, സോഴ്സിംഗ് എന്നിവയിലേക്ക് ടീമുകൾ മാറുമ്പോൾ ഏറ്റവും കൂടുതൽ ഉയർന്നുവരുന്ന ചോദ്യങ്ങളാണിവ.
ഒരു കസ്റ്റം NER മോഡലിനെ പരിശീലിപ്പിക്കാൻ എനിക്ക് എത്ര ലേബൽ ചെയ്ത ഡാറ്റ ആവശ്യമാണ്?
ഒരു പ്രായോഗിക ആരംഭ പോയിന്റായി ഓരോ എന്റിറ്റി തരത്തിനും ആയിരക്കണക്കിന് വ്യാഖ്യാനിച്ച ഉദാഹരണങ്ങൾ ആസൂത്രണം ചെയ്യുക - യഥാർത്ഥ ലോകത്തിലെ ഇഷ്ടാനുസൃത NER മോഡലുകൾ പലപ്പോഴും ആയിരക്കണക്കിന് സാമ്പിളുകളിൽ പരിശീലിപ്പിക്കപ്പെടുന്നു. ആദ്യം മുതൽ പരിശീലനം നൽകുന്നതിന് വളരെയധികം ആവശ്യമുണ്ട്, അതിനാൽ മിക്ക ടീമുകളും പകരം മുൻകൂട്ടി പരിശീലിപ്പിച്ച ഒരു മോഡലിനെ മികച്ചതാക്കുന്നു. ലേബലുകളുടെ ഗുണനിലവാരവും സ്ഥിരതയും അസംസ്കൃത വോളിയത്തേക്കാൾ പ്രധാനമാണ്; ശബ്ദായമാനമായ ഡാറ്റ കൃത്യത വേഗത്തിലാക്കുന്നു.
എന്റെ NER പരിശീലന ഡാറ്റാസെറ്റ് ഞാൻ സ്വന്തമായി നിർമ്മിക്കണോ അതോ അനോട്ടേഷൻ ഔട്ട്സോഴ്സ് ചെയ്യണോ?
വോളിയം, വേഗത, ഡൊമെയ്ൻ വൈദഗ്ദ്ധ്യം അല്ലെങ്കിൽ അനുസരണം എന്നിവ ആവശ്യമുള്ളപ്പോൾ നിങ്ങൾക്ക് ആന്തരികമായി സ്റ്റാഫ് ചെയ്യാൻ കഴിയില്ല; നിങ്ങളുടെ സ്കീമ ലളിതവും സ്ഥിരതയുള്ളതും ചെറുതുമാകുമ്പോൾ മാത്രം ഇൻ-ഹൗസ് നിർമ്മിക്കുക. മിക്ക ടീമുകളും അനോട്ടേഷനെ കുറച്ചുകാണുന്നു - മാർഗ്ഗനിർദ്ദേശങ്ങൾ, ലേബലിംഗ്, QA എന്നിവ ഒരു NER പ്രോജക്റ്റിന്റെ ഭൂരിഭാഗവും ഉപയോഗിക്കുന്നു. Shaip പോലുള്ള ഒരു പ്രത്യേക പങ്കാളി ആ ലോഡ് ആഗിരണം ചെയ്യുന്നു, അതിനാൽ നിങ്ങളുടെ എഞ്ചിനീയർമാർ ലേബലിംഗിലല്ല, മോഡലിംഗിലാണ് ശ്രദ്ധ കേന്ദ്രീകരിക്കുന്നത്.
എന്റെ NER മോഡലിൽ ഡൊമെയ്ൻ-നിർദ്ദിഷ്ട എന്റിറ്റികൾ നഷ്ടപ്പെട്ടുകൊണ്ടിരിക്കുന്നത് എന്തുകൊണ്ട്?
പൊതു ഉദ്ദേശ്യ മോഡലുകൾക്ക് വാർത്തകളിലും വെബ് ടെക്സ്റ്റിലും പരിശീലനം നൽകുന്നതിനാൽ, മരുന്നുകളുടെ പേരുകൾ, നിയമപരമായ വ്യവസ്ഥകൾ അല്ലെങ്കിൽ സാമ്പത്തിക ഉപകരണങ്ങൾ പോലുള്ള പ്രത്യേക പദങ്ങൾ അവർ വളരെ അപൂർവമായി മാത്രമേ തിരിച്ചറിയൂ. യഥാർത്ഥ സന്ദർഭത്തിൽ ആ എന്റിറ്റികൾ ഉൾക്കൊള്ളുന്ന വ്യാഖ്യാനിച്ച, ഇൻ-ഡൊമെയ്ൻ ഡാറ്റയിൽ മികച്ച രീതിയിൽ ട്യൂൺ ചെയ്യുക എന്നതാണ് പരിഹാരം. പൊരുത്തമില്ലാത്ത ലേബലിംഗ് മാർഗ്ഗനിർദ്ദേശങ്ങളാണ് മറ്റൊരു സാധാരണ കുറ്റവാളി, അതിനാൽ സ്കെയിലിംഗ് ചെയ്യുന്നതിന് മുമ്പ് നിങ്ങളുടെ വ്യാഖ്യാന നിയമങ്ങൾ പൂട്ടിയിടുക.
ഒരു ഇഷ്ടാനുസൃത NER ഡാറ്റാസെറ്റ് നിർമ്മിക്കുന്നതിന് എത്ര ചിലവാകും?
എന്റിറ്റി സങ്കീർണ്ണത, വ്യാഖ്യാന അളവ്, ആവശ്യമായ ഡൊമെയ്ൻ വൈദഗ്ദ്ധ്യം, അനുസരണ ആവശ്യകതകൾ എന്നിവയെ ആശ്രയിച്ചിരിക്കും ചെലവ് - ക്ലിനിക്കൽ അല്ലെങ്കിൽ നിയമപരമായ ലേബലിംഗിന് പൊതുവായ വാചകത്തേക്കാൾ കൂടുതൽ ചിലവ് വരും, കാരണം ഇതിന് വിദഗ്ദ്ധ വ്യാഖ്യാനകരും കർശനമായ QA ഉം ആവശ്യമാണ്. വില സാധാരണയായി ഓരോ പേജിനും, ഓരോ ഡോക്യുമെന്റിനും അല്ലെങ്കിൽ വ്യാഖ്യാനിച്ച യൂണിറ്റിനും ഉദ്ധരിക്കുന്നു. Shaip ഓരോ NER പ്രോജക്റ്റിനെയും നിങ്ങളുടെ സ്കീമയിലേക്കും ഗുണനിലവാര ബാറിലേക്കും സ്കോപ്പ് ചെയ്യുകയും അനുയോജ്യമായ ഒരു ഉദ്ധരണി നൽകുകയും ചെയ്യുന്നു.
ഉയർന്ന നിലവാരമുള്ള NER അല്ലെങ്കിൽ ക്ലിനിക്കൽ NER പരിശീലന ഡാറ്റ എനിക്ക് എവിടെ നിന്ന് ലഭിക്കും?
NER പരിശീലന ഡാറ്റ മൂന്ന് വിധത്തിൽ ലഭ്യമാക്കുന്നു: ഒരു ഓഫ്-ദി-ഷെൽഫ് ഡാറ്റാസെറ്റിന് ലൈസൻസ് നൽകുക, ഒരു ഇഷ്ടാനുസൃത ഡാറ്റാസെറ്റ് ശേഖരിക്കുകയും വ്യാഖ്യാനിക്കുകയും ചെയ്യുക, അല്ലെങ്കിൽ നിലവിലുള്ള ഒരു കോർപ്പസ് വിപുലീകരിക്കുക. ഡൊമെയ്ൻ-നിർദ്ദിഷ്ട അല്ലെങ്കിൽ നിയന്ത്രിത ജോലികൾക്ക് - മെഡിക്കൽ, നിയമപരമായ, സാമ്പത്തിക - ഒരു നിയന്ത്രിത അനോട്ടേഷൻ ദാതാവാണ് വിശ്വസനീയമായ മാർഗം. Shaip നിങ്ങളുടെ കൃത്യമായ സ്പെസിഫിക്കേഷനുകൾക്ക് അനുസൃതമായി നിർമ്മിച്ച ഇഷ്ടാനുസൃത NER ഡാറ്റാസെറ്റുകൾ, ക്ലിനിക്കൽ NER, HIPAA-അനുസൃതമായ ഡി-ഐഡന്റിഫിക്കേഷൻ എന്നിവ നൽകുന്നു.
NER, എന്റിറ്റി എക്സ്ട്രാക്ഷൻ, എന്റിറ്റി ലിങ്കിംഗ് എന്നിവ തമ്മിലുള്ള വ്യത്യാസം എന്താണ്?
എന്റിറ്റികളെ തരം (വ്യക്തി, സ്ഥാപനം, സ്ഥാനം) അനുസരിച്ച് NER കണ്ടെത്തി തരംതിരിക്കുന്നു. എന്റിറ്റി എക്സ്ട്രാക്ഷൻ പലപ്പോഴും NER എന്നതിന് പകരമായി ഉപയോഗിക്കുന്നു, ചിലപ്പോൾ ടെക്സ്റ്റിൽ നിന്ന് ഘടനാപരമായ ഫീൽഡുകൾ വലിച്ചെടുക്കുന്നതിന് കൂടുതൽ വിശാലമായി. എന്റിറ്റി ലിങ്കിംഗ് ഒരു പടി കൂടി മുന്നോട്ട് പോകുന്നു, ഒരു അംഗീകൃത എന്റിറ്റിയെ ഒരു വിജ്ഞാന അടിത്തറയിലെ ഒരു അദ്വിതീയ റെക്കോർഡിലേക്ക് ബന്ധിപ്പിക്കുന്നു - ഏത് "ആപ്പിൾ" അല്ലെങ്കിൽ ഏത് "ജോർദാൻ" എന്നാണ് ഉദ്ദേശിക്കുന്നതെന്ന് പരിഹരിക്കുന്നു.
തീരുമാനം
എൻ്റിറ്റി റെക്കഗ്നിഷൻ (NER) എന്നത് ഒരു ശക്തമായ NLP സാങ്കേതികതയാണ്, അത് ടെക്സ്റ്റിനുള്ളിലെ പ്രധാന എൻ്റിറ്റികളെ തിരിച്ചറിയുകയും തരംതിരിക്കുകയും ചെയ്യുന്നു, ഇത് മനുഷ്യ ഭാഷ കൂടുതൽ ഫലപ്രദമായി മനസ്സിലാക്കാനും പ്രോസസ്സ് ചെയ്യാനും മെഷീനുകളെ പ്രാപ്തമാക്കുന്നു. സെർച്ച് എഞ്ചിനുകളും ചാറ്റ്ബോട്ടുകളും മെച്ചപ്പെടുത്തുന്നത് മുതൽ ഉപഭോക്തൃ പിന്തുണയും സാമ്പത്തിക വിശകലനവും ശക്തിപ്പെടുത്തുന്നത് വരെ, വിവിധ വ്യവസായങ്ങളിൽ ഉടനീളം NER ന് വൈവിധ്യമാർന്ന ആപ്ലിക്കേഷനുകൾ ഉണ്ട്. അവ്യക്തത പരിഹരിക്കുക, ഘടനാരഹിതമായ ഡാറ്റ കൈകാര്യം ചെയ്യുക തുടങ്ങിയ മേഖലകളിൽ വെല്ലുവിളികൾ നിലനിൽക്കുന്നുണ്ടെങ്കിലും, നിലവിലുള്ള പുരോഗതികൾ, പ്രത്യേകിച്ച് ആഴത്തിലുള്ള പഠനത്തിൽ, NER-ൻ്റെ കഴിവുകൾ കൂടുതൽ പരിഷ്കരിക്കുമെന്നും ഭാവിയിൽ അതിൻ്റെ സ്വാധീനം വിപുലീകരിക്കുമെന്നും വാഗ്ദാനം ചെയ്യുന്നു.




