രാത്രി 9 മണിക്ക് നിങ്ങളുടെ ബാങ്കിൽ വിളിച്ച് ചാർജ് തർക്കിക്കാൻ ആവശ്യപ്പെടുക. ഒരു ശബ്ദം കേൾക്കുന്നു, ആദ്യ ശ്രമത്തിൽ തന്നെ പ്രശ്നം മനസ്സിലാക്കുന്നു, ഇടപാട് പൂർത്തിയാക്കുന്നു, നിങ്ങളുടെ ഐഡന്റിറ്റി സ്ഥിരീകരിക്കുന്നു, അത് പരിഹരിക്കുന്നു - സംഗീതമില്ല, കൈമാറ്റമില്ല, "പ്രധാന മെനുവിലേക്ക് മടങ്ങാൻ 4 അമർത്തുക" എന്നില്ല. ആ ഇടപെടൽ AI യുടെ വിജയമായി തോന്നുന്നു.

അങ്ങനെയാണ്. പക്ഷേ, മിക്ക ആളുകളും കരുതുന്ന രീതിയിലല്ല. ഇപ്പോൾ ആ മോഡൽ വലിയൊരു വിൽപ്പനച്ചരക്കാണ്. നിങ്ങളെപ്പോലെ സംസാരിക്കുന്ന ആളുകളുടെ ആയിരക്കണക്കിന് മണിക്കൂർ റെക്കോർഡ് ചെയ്ത പ്രസംഗമാണ് ആ കോൾ പ്രവർത്തനക്ഷമമാക്കിയത്, "ഒരു ചാർജ് തർക്കിക്കുക" എന്നതിന്റെ അർത്ഥം എന്താണെന്ന് അംഗീകരിച്ച വ്യാഖ്യാനകർ അവരെ മുദ്രകുത്തി, സിസ്റ്റം യഥാർത്ഥത്തിൽ കേൾക്കുന്ന ഉച്ചാരണങ്ങൾക്കും പദപ്രയോഗങ്ങൾക്കും വേണ്ടി സ്ക്രീൻ ചെയ്തു, ആരുടെയും ശബ്ദം സമ്മതമില്ലാതെ ഒരു പരിശീലന സെറ്റിൽ എത്താത്തവിധം നിയന്ത്രിച്ചു.
2026-ൽ സംഭാഷണാധിഷ്ഠിത AI-യുടെ യഥാർത്ഥ കഥ അതാണ്. ഏകദേശം 21% CAGR-ൽ വിപണി $82.46B- ലേക്ക് കുതിക്കുന്നു , 78% സ്ഥാപനങ്ങളും ഇപ്പോൾ കുറഞ്ഞത് ഒരു ബിസിനസ് ഫംഗ്ഷനിലെങ്കിലും AI ഉപയോഗിക്കുന്നു, കൂടാതെ 75% സ്ഥാപനങ്ങളും ഉപഭോക്തൃ പിന്തുണയ്ക്കായി വലിയ ഭാഷാ മോഡലുകൾ വിന്യസിക്കാൻ തയ്യാറാണ്. സാങ്കേതികവിദ്യ പരിഹരിച്ചു. ഡിഫറൻഷ്യേറ്റർ സ്റ്റാക്കിൽ നിന്ന് താഴേക്ക്, ഡാറ്റയിലേക്ക് നീങ്ങിയിരിക്കുന്നു. മുഴുവൻ കാര്യവും എങ്ങനെ യോജിക്കുന്നുവെന്ന് ഇതാ.
സംഭാഷണ AI യഥാർത്ഥത്തിൽ എന്താണ്?
സംഭാഷണ AI എന്നത് ചാറ്റ്ബോട്ടുകൾ, വെർച്വൽ ഏജന്റുകൾ, വോയ്സ് അസിസ്റ്റന്റുകൾ എന്നിങ്ങനെയുള്ള സിസ്റ്റങ്ങളുടെ ഒരു കുടുംബമാണ്. ഇവ സംഭാഷണ തിരിച്ചറിയൽ, സ്വാഭാവിക ഭാഷാ ധാരണ, സംഭാഷണ ഉൽപ്പാദനം എന്നിവ സംയോജിപ്പിച്ച് സ്വാഭാവികവും മുന്നോട്ടും പിന്നോട്ടും സംഭാഷണം നടത്തുകയും ഓരോ തവണ ഉപയോഗിക്കുമ്പോഴും മികച്ചതാകുകയും ചെയ്യുന്നു.
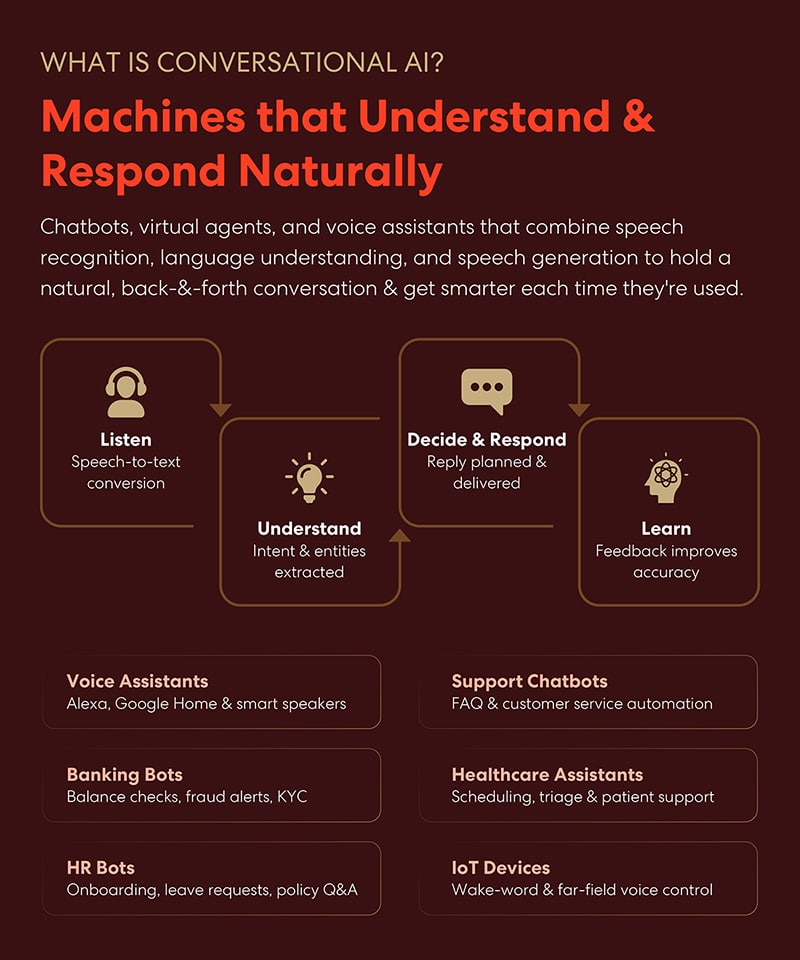
വൈവിധ്യത്തിന് കീഴിൽ, അവയെല്ലാം ഒരേ നാല്-ഘട്ട ലൂപ്പാണ് പ്രവർത്തിപ്പിക്കുന്നത്.
- സംവിധാനം ശ്രദ്ധിക്കുന്നു, സംഭാഷണത്തെ വാചകമാക്കി മാറ്റുന്നു.
- It മനസ്സിലാക്കുന്നു, ഉദ്ദേശ്യവും എന്റിറ്റികളും വേർതിരിച്ചെടുക്കൽ - ഉപയോക്താവിന് എന്താണ് വേണ്ടത്, ആ ആവശ്യവുമായി ബന്ധിപ്പിച്ചിരിക്കുന്ന നിർദ്ദിഷ്ട വിശദാംശങ്ങൾ.
- It തീരുമാനിക്കുകയും പ്രതികരിക്കുകയും ചെയ്യുന്നു, ഒരു മറുപടി ആസൂത്രണം ചെയ്ത് അത് എത്തിക്കുക.
- അത് പഠിക്കുന്നു, അടുത്ത ഊഴത്തിലും അടുത്ത ഉപയോക്താവിലും കൃത്യത മെച്ചപ്പെടുത്തുന്നതിന് ഫീഡ്ബാക്ക് സിഗ്നലുകൾ ഉപയോഗിക്കുന്നു.
കേൾക്കുക → മനസ്സിലാക്കുക → തീരുമാനിക്കുക → പഠിക്കുക. താഴെയുള്ള ഓരോ ഉൽപ്പന്നവും ഒരേ ലൂപ്പിൽ പൊതിഞ്ഞ വ്യത്യസ്ത ഡൊമെയ്നാണ്.
- വോയ്സ് സഹായികൾ അലക്സയും ഗൂഗിൾ ഹോം പോലുള്ളവയും സ്മാർട്ട് സ്പീക്കറുകൾ വഴി ഓപ്പൺ-എൻഡ് ഗാർഹിക അഭ്യർത്ഥനകൾ കൈകാര്യം ചെയ്യുന്നു.
- ചാറ്റ്ബോട്ടുകളെ പിന്തുണയ്ക്കുക FAQ കൈകാര്യം ചെയ്യലും ഉപഭോക്തൃ സേവന ട്രയേജും ഓട്ടോമേറ്റ് ചെയ്യുക.
- ബാങ്കിംഗ് ബോട്ടുകൾ ബാലൻസ് പരിശോധനകൾ, തട്ടിപ്പ് അലേർട്ടുകൾ, KYC പരിശോധന എന്നിവ നടത്തുക.
- ഹെൽത്ത് കെയർ അസിസ്റ്റന്റുമാർ ഷെഡ്യൂളിംഗ്, രോഗലക്ഷണങ്ങളുടെ വർഗ്ഗീകരണം, രോഗി പിന്തുണ എന്നിവ കൈകാര്യം ചെയ്യുക.
- എച്ച്ആർ ബോട്ടുകൾ ഫീൽഡ് ഓൺബോർഡിംഗ് ചോദ്യങ്ങൾ, ലീവ് അഭ്യർത്ഥനകൾ, നയ ചോദ്യോത്തരങ്ങൾ എന്നിവ നൽകുക.
- ഒപ്പം IoT ഉപകരണങ്ങൾ വേക്ക്-വേഡ് ഡിറ്റക്ഷനെയും ഫാർ-ഫീൽഡ് വോയ്സ് നിയന്ത്രണത്തെയും ആശ്രയിക്കുക, അവിടെ മൈക്രോഫോൺ മുറിയുടെ എതിർവശത്തായിരിക്കുകയും ഉപയോക്താവ് സ്ക്രീനിൽ നോക്കാതിരിക്കുകയും ചെയ്യുന്നു.
ഒരേ പൈപ്പ്ലൈൻ, തികച്ചും വ്യത്യസ്തമായ പരാജയ സാഹചര്യങ്ങൾ. ഉദ്ദേശ്യം തെറ്റായി വായിക്കുന്ന ഒരു റീട്ടെയിൽ ചാറ്റ്ബോട്ടിന് ഒരു പരിവർത്തനം ആവശ്യമാണ്. ഉദ്ദേശ്യം തെറ്റായി വായിക്കുന്ന ഒരു ഹെൽത്ത്കെയർ ട്രയേജ് അസിസ്റ്റന്റ് രോഗി-സുരക്ഷാ സംഭവമാണ്. ആ വ്യത്യാസം ആർക്കിടെക്ചറിലല്ല, ഡാറ്റയിലാണ് പരിഹരിക്കപ്പെടുന്നത്.
റോ സ്പീച്ച് എങ്ങനെയാണ് പരിശീലന ഡാറ്റയായി മാറുന്നത്
ഒരു റെക്കോർഡിംഗിൽ നിന്ന് ഒരു മോഡൽ-റെഡി ഡാറ്റാസെറ്റിലേക്ക് എത്തുന്നതിന് രണ്ട് വ്യത്യസ്ത പാസുകൾ ആവശ്യമാണ്: സംഭാഷണം എങ്ങനെ ശേഖരിക്കണമെന്ന് തിരഞ്ഞെടുക്കുക, തുടർന്ന് ഒരു മോഡലിന് അതിൽ നിന്ന് പഠിക്കാൻ കഴിയുന്ന തരത്തിൽ ലേബൽ ചെയ്യുക. ഇവയെ ഒരു ഘട്ടമായി കണക്കാക്കുന്ന ടീമുകൾ തെറ്റായ കാര്യങ്ങൾ പഠിപ്പിക്കുന്ന ഒരു വലിയ ഡാറ്റാസെറ്റിൽ അവസാനിക്കുന്നു.
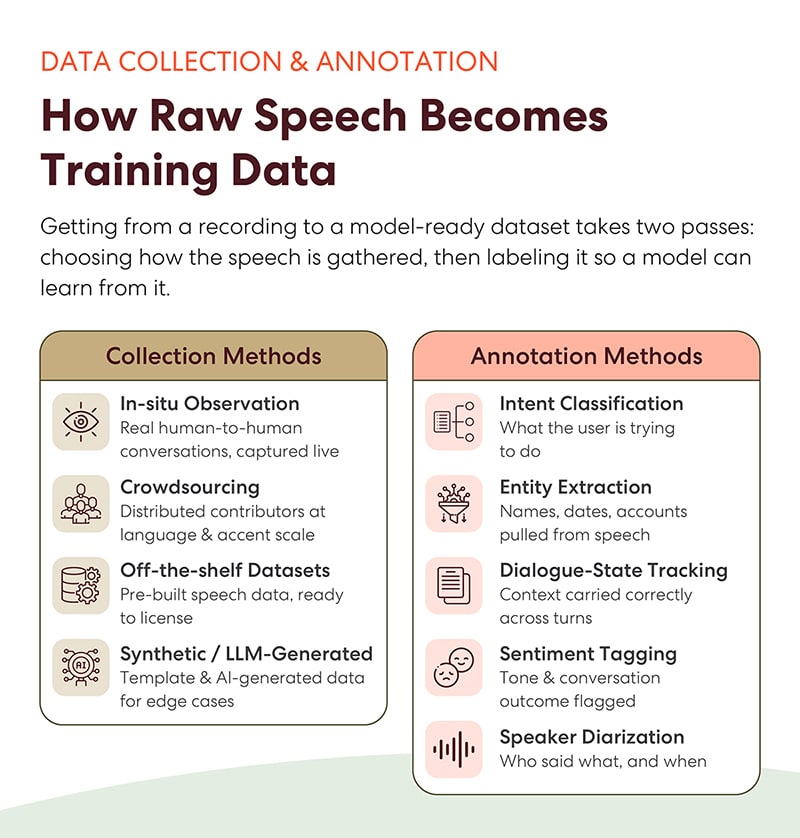
ശേഖരണത്തിന്റെ കാര്യത്തിൽ , മിക്ക ആവശ്യങ്ങളും നിറവേറ്റുന്നത് നാല് രീതികളാണ്.
- ഇൻ-സൈറ്റു നിരീക്ഷണം മനുഷ്യർ തമ്മിലുള്ള യഥാർത്ഥ സംഭാഷണങ്ങൾ തത്സമയം പകർത്തുന്നു — ലഭ്യമായ ഏറ്റവും വിശ്വസ്തമായ സിഗ്നലും, സ്കെയിലിൽ ലഭിക്കാൻ ഏറ്റവും പ്രയാസമുള്ളതുമാണ്.
- ക്രോഡ്സോഴ്സിംഗ് ഭാഷയും ഉച്ചാരണവും അനുസരിച്ച് തിരഞ്ഞെടുത്ത സംഭാവകർക്ക് റെക്കോർഡിംഗ് വിതരണം ചെയ്യുന്നു, അങ്ങനെയാണ് കവറേജ് ആകസ്മികമായി നിർമ്മിക്കുന്നതിനുപകരം മനഃപൂർവ്വം നിർമ്മിക്കുന്നത്.
- ഓഫ്-ദി-ഷെൽഫ് ഡാറ്റാസെറ്റുകൾ മുൻകൂട്ടി നിർമ്മിച്ചതും മുൻകൂട്ടി ക്ലിയർ ചെയ്തതുമായ സംഭാഷണ ഡാറ്റ ലൈസൻസിന് തയ്യാറാണ്, ഡൊമെയ്ൻ ന്യായമായ പൊരുത്തമുള്ളപ്പോൾ മാസങ്ങൾ ഒരു ടൈംലൈനിൽ നിന്ന് വെട്ടിക്കുറയ്ക്കുന്നു.
- ഒപ്പം സിന്തറ്റിക് അല്ലെങ്കിൽ എൽഎൽഎം-ജനറേറ്റഡ് കാത്തിരിക്കാൻ വളരെ അപൂർവമായ കേസുകൾക്കായി ടെംപ്ലേറ്റ് അടിസ്ഥാനമാക്കിയുള്ളതും AI- ജനറേറ്റുചെയ്തതുമായ പ്രസ്താവനകൾ - നിർദ്ദിഷ്ട വിടവുകൾ നികത്തുന്നു - ഡാറ്റ.
അനോട്ടേഷൻ ഭാഗത്ത്, അഞ്ച് ലേബലിംഗ് ലെയറുകൾ ഓഡിയോയെ മേൽനോട്ടമാക്കി മാറ്റുന്നു.
- ഉദ്ദേശ്യ വർഗ്ഗീകരണം ഉപയോക്താവ് എന്താണ് ചെയ്യാൻ ശ്രമിക്കുന്നതെന്ന് ടാഗുചെയ്യുന്നു.
- എന്റിറ്റി എക്സ്ട്രാക്ഷൻ പ്രസംഗത്തിൽ നിന്ന് പേരുകൾ, തീയതികൾ, അക്കൗണ്ട് നമ്പറുകൾ എന്നിവ പുറത്തെടുക്കുന്നു.
- ഡയലോഗ്-സ്റ്റേറ്റ് ട്രാക്കിംഗ് ടേണുകളിലൂടെ സന്ദർഭം കൊണ്ടുപോകുന്നു, അതിനാൽ "രണ്ടാമത്തെ" എന്നത് നാല് ടേണുകൾക്ക് മുമ്പ് പരാമർശിച്ച ഒന്നിനെയാണ് സൂചിപ്പിക്കുന്നതെന്ന് സിസ്റ്റത്തിന് അറിയാം.
- സെന്റിമെന്റ് ടാഗിംഗ് സംഭാഷണത്തിന്റെ സ്വരവും ഫലവും ഫ്ലാഗ് ചെയ്യുന്നു.
- ഒപ്പം സ്പീക്കർ ഡയറൈസേഷൻ ആര് എന്ത് പറഞ്ഞു, എപ്പോൾ പറഞ്ഞു എന്ന് സ്ഥാപിക്കുന്നു - ഏതൊരു മൾട്ടി-പാർട്ടി റെക്കോർഡിംഗിനും, അതായത് മിക്ക യഥാർത്ഥ കോൾ ഡാറ്റയ്ക്കും മാറ്റാൻ കഴിയില്ല.
ശേഖരിക്കുക → ട്രാൻസ്ക്രൈബ് ചെയ്യുക → ലേബൽ ഇന്റന്റുകളും എന്റിറ്റികളും → ട്രാക്ക് സ്റ്റേറ്റ് → ഡയറൈസ് ചെയ്യുക → സാധൂകരിക്കുക. ഒരു ലെയർ ഒഴിവാക്കുക, നിങ്ങൾക്ക് ഒന്നും മനസ്സിലാകാതെ സുഗമമായി ട്രാൻസ്ക്രൈബ് ചെയ്യുന്ന ഒരു മോഡൽ ലഭിക്കും.
"നല്ല ഡാറ്റ" യഥാർത്ഥത്തിൽ അളക്കുന്നത് എന്താണ്?
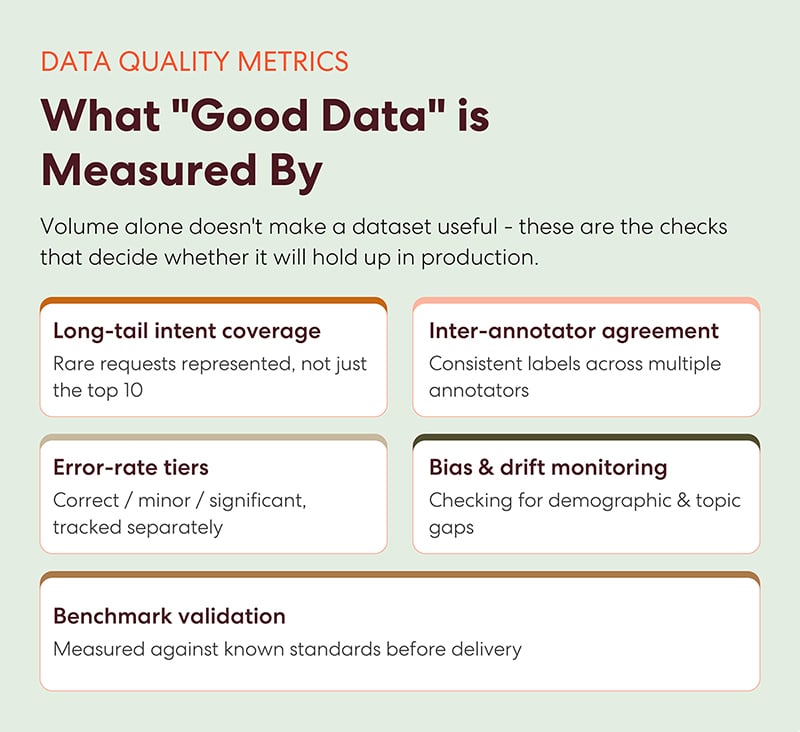
ഒരു ഡാറ്റാസെറ്റിന്റെ അളവ് മാത്രം ഉപയോഗപ്രദമാകണമെന്നില്ല. അഞ്ച് പരിശോധനകൾ അത് ഉൽപാദനത്തിൽ നിലനിൽക്കുമോ എന്ന് തീരുമാനിക്കുന്നു, കൂടാതെ ഏത് വെണ്ടറോടും നേരിട്ട് ചോദിക്കുന്നത് മൂല്യവത്താണ്.
- ലോങ്-ടെയിൽ ഇന്റന്റ് കവറേജ് അപൂർവമായ അഭ്യർത്ഥനകൾ പ്രതിനിധീകരിക്കപ്പെടുന്നുണ്ടോ എന്ന് ചോദിക്കുന്നു, ആദ്യ പത്ത് പേരുടെ പേരുകൾ മാത്രമല്ല. മിക്ക ഡാറ്റാസെറ്റുകളിലും ഉപയോക്താക്കൾ നിരന്തരം ഹിറ്റ് ചെയ്യുന്ന ചുരുക്കം ചില ഉദ്ദേശ്യങ്ങൾ ആധിപത്യം പുലർത്തുന്നു - മിക്ക ഉൽപാദന പരാജയങ്ങളും അവസാനം സംഭവിക്കുന്നു.
- ഇന്റർ-അനോട്ടർ കരാർ ഒന്നിലധികം വ്യാഖ്യാതാക്കൾ ഒരേ ഉച്ചാരണത്തെ ഒരേ രീതിയിൽ ലേബൽ ചെയ്യുന്നുണ്ടോ എന്ന് അളക്കുന്നു; കുറഞ്ഞ ധാരണ എന്നാൽ നിങ്ങളുടെ ലേബലുകൾ അടിസ്ഥാന സത്യത്തിന് പകരം ആശയക്കുഴപ്പം എൻകോഡ് ചെയ്യുന്നു എന്നാണ്.
- പിശക് നിരക്ക് ശ്രേണികൾ പ്രധാന പിശകുകളിൽ നിന്ന് ശരിയും ചെറുതും വേർതിരിച്ച് അവയെ സ്വതന്ത്രമായി ട്രാക്ക് ചെയ്യുക, കാരണം വിനാശകരമായ തെറ്റായ വർഗ്ഗീകരണങ്ങൾ അടങ്ങിയ 3% പിശക് നിരക്ക് നിസ്സാരമായവയുടെ 3% നിരക്കിന് തുല്യമല്ല.
- ബയസ്, ഡ്രിഫ്റ്റ് നിരീക്ഷണം ജനസംഖ്യാപരമായും വിഷയപരമായും ഉള്ള വിടവുകൾ പരിശോധിക്കുകയും, ഭാഷയും ഉപയോക്തൃ പെരുമാറ്റവും മാറുന്നതിനനുസരിച്ച് കാലക്രമേണ അവ നിരീക്ഷിക്കുകയും ചെയ്യുന്നു.
- ഒപ്പം ബെഞ്ച്മാർക്ക് വാലിഡേഷൻ ഡെലിവറിക്ക് മുമ്പ് അറിയപ്പെടുന്ന മാനദണ്ഡങ്ങൾക്കെതിരെ ഡാറ്റാസെറ്റ് അളക്കുന്നു, അതിനാൽ അത് നിങ്ങളുടെ പ്രശ്നമാകുന്നതിന് മുമ്പ് ഗുണനിലവാരം സ്ഥാപിക്കപ്പെടുന്നു.
നിങ്ങൾക്ക് വിന്യസിക്കാൻ കഴിയുന്ന ഒരു ഡാറ്റാസെറ്റും വീണ്ടും ചെയ്യേണ്ട ഒരു ഡാറ്റാസെറ്റും തമ്മിലുള്ള വ്യത്യാസമാണ് ഈ അഞ്ച്.
ബോൾട്ട് ചെയ്തിട്ടില്ല, ഡാറ്റാ ലെയറിലാണ് വിശ്വാസം ഉൾച്ചേർത്തിരിക്കുന്നത്.
സംഭാഷണ ഡാറ്റയിൽ ഒരു വ്യക്തിയുടെ ശബ്ദവും വാക്കുകളും ഉൾപ്പെടുന്നു - അവരെക്കുറിച്ചുള്ള ഏറ്റവും തിരിച്ചറിയാവുന്ന രണ്ട് കാര്യങ്ങൾ. ശേഖരണം മുതൽ തന്നെ ഭരണം രൂപകൽപ്പന ചെയ്യേണ്ടതുണ്ട്, കാരണം നിങ്ങൾ ഇതിനകം പരിശീലിപ്പിച്ച ഒരു റെക്കോർഡിംഗിലേക്ക് മുൻകാല പ്രാബല്യത്തോടെ സമ്മതം ചേർക്കാൻ ഒരു മാർഗവുമില്ല.
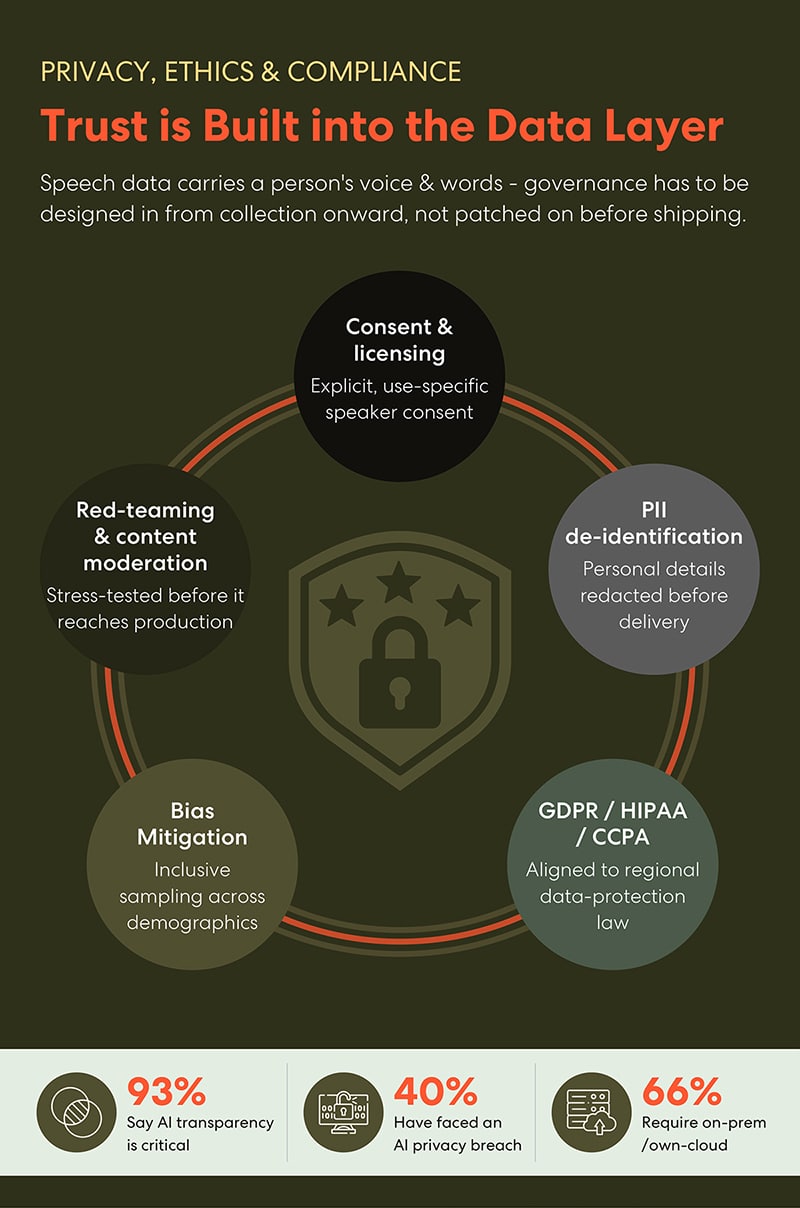
അഞ്ച് നിയന്ത്രണങ്ങൾ ഒരു പ്രതിരോധ ഡാറ്റ ലെയറിനെ നിർവചിക്കുന്നു.
- സമ്മതവും ലൈസൻസിംഗും ഉപയോഗത്തിനനുസരിച്ചുള്ള സ്പീക്കറുടെ വ്യക്തമായ സമ്മതം എന്നാണ് അർത്ഥമാക്കുന്നത് - സേവന നിബന്ധനകൾക്കുള്ള ഒരു വ്യവസ്ഥയല്ല.
- PII തിരിച്ചറിയൽ ഇല്ലാതാക്കൽ ഒരു സംഭവത്തിന് ശേഷമല്ല, ഡെലിവറിക്ക് മുമ്പ് വ്യക്തിഗത വിവരങ്ങൾ മറയ്ക്കുന്നു.
- GDPR, HIPAA, CCPA വിന്യാസം വിന്യാസത്തിന് യഥാർത്ഥത്തിൽ ബാധകമായ പ്രാദേശിക ഡാറ്റാ-സംരക്ഷണ നിയമവുമായി പൈപ്പ്ലൈൻ മാപ്പ് ചെയ്യുന്നു.
- പക്ഷപാത ലഘൂകരണം ജനസംഖ്യാശാസ്ത്രത്തിലുടനീളം ഉൾക്കൊള്ളുന്ന സാമ്പിളുകൾ ശേഖരണ പദ്ധതിയിലേക്ക് നിർമ്മിക്കുന്നു, അവിടെ പരിഹാരത്തിന് ചെലവാകുന്നതിനുപകരം, എല്ലാം ചെലവാകുന്നിടത്ത്.
- ഒപ്പം റെഡ്-ടീമിംഗും ഉള്ളടക്ക മോഡറേഷനും പ്രൊഡക്ഷൻ ഉപയോക്താക്കളിലേക്ക് എത്തുന്നതിനുമുമ്പ് സിസ്റ്റത്തെ സമ്മർദ്ദ പരിശോധനയ്ക്ക് വിധേയമാക്കുന്നു.
വിപണി ഇതിന് വില നിശ്ചയിച്ചിട്ടുണ്ട്. 93% സ്ഥാപനങ്ങളും പറയുന്നത് AI സുതാര്യത നിർണായകമാണെന്നും 40% സ്ഥാപനങ്ങൾ ഇതിനകം AI സ്വകാര്യതാ ലംഘനം നേരിട്ടിട്ടുണ്ടെന്നും 66% സ്ഥാപനങ്ങൾക്ക് ഇപ്പോൾ ഓൺ-പ്രെമൈസ് അല്ലെങ്കിൽ സ്വന്തം ക്ലൗഡ് വിന്യാസം ആവശ്യമാണെന്നും ആണ്. ഡാറ്റ എവിടെ നിന്നാണ് വന്നതെന്ന് വാങ്ങുന്നവർ ചോദിക്കുന്നു - കൂടാതെ, ഒരു കരാറിൽ ഉത്തരം ലഭിക്കണമെന്ന് അവർ കൂടുതലായി ആഗ്രഹിക്കുന്നു.
സംഭാഷണ AI ദൃശ്യമാകുന്നിടത്ത്
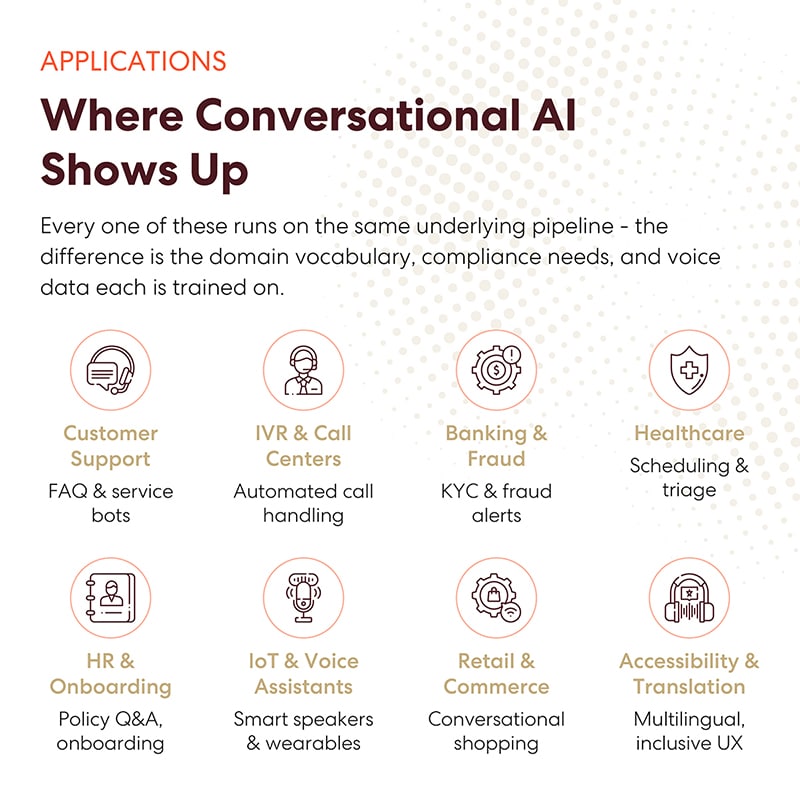
മിക്ക എന്റർപ്രൈസ് വിന്യാസത്തിനും എട്ട് ആപ്ലിക്കേഷൻ ഏരിയകൾ കാരണമാകുന്നു.
- ഉപഭോക്തൃ പിന്തുണ FAQ, സർവീസ് ബോട്ടുകൾ പ്രവർത്തിപ്പിക്കുന്നു.
- IVR ഉം കോൾ സെന്ററുകളും കോൾ കൈകാര്യം ചെയ്യലും റൂട്ടിംഗും ഓട്ടോമേറ്റ് ചെയ്യുന്നു.
- ബാങ്കിംഗും തട്ടിപ്പും KYC പരിശോധനയും തട്ടിപ്പ് മുന്നറിയിപ്പും ഉൾക്കൊള്ളുന്നു.
- ആരോഗ്യ പരിരക്ഷ ഷെഡ്യൂളിംഗും ട്രയേജും കൈകാര്യം ചെയ്യുന്നു.
- എച്ച്ആറും ഓൺബോർഡിംഗും നയപരമായ ചോദ്യോത്തരങ്ങളും പുതുതായി നിയമിക്കപ്പെടുന്നവരുടെ വർക്ക്ഫ്ലോകളും കൈകാര്യം ചെയ്യുന്നു.
- IoT, വോയ്സ് അസിസ്റ്റന്റുകൾ പവർ സ്മാർട്ട് സ്പീക്കറുകളും വെയറബിളുകളും.
- ചില്ലറ വ്യാപാരവും വാണിജ്യവും സംഭാഷണ ഷോപ്പിംഗ് സാധ്യമാക്കുന്നു.
- ഒപ്പം പ്രവേശനക്ഷമതയും വിവർത്തനവും സ്റ്റാൻഡേർഡ് ഇന്റർഫേസ് ഒഴിവാക്കുന്ന ബഹുഭാഷാ, ഉൾക്കൊള്ളുന്ന ഉപയോക്തൃ അനുഭവം ആളുകൾക്ക് നൽകുന്നു.
ഇവയിൽ ഓരോന്നും ഒരേ അടിസ്ഥാന പൈപ്പ്ലൈനിലാണ് പ്രവർത്തിക്കുന്നത്. വ്യത്യാസം ഡൊമെയ്ൻ പദാവലി, അനുസരണ ആവശ്യകതകൾ, ഓരോരുത്തരും പരിശീലിപ്പിക്കപ്പെടുന്ന വോയ്സ് ഡാറ്റ എന്നിവയാണ്. ടീമുകൾ കുറഞ്ഞ നിക്ഷേപം നടത്തുന്നതും ഡെമോയ്ക്ക് പുറത്ത് വിന്യാസം പ്രവർത്തിക്കുന്നുണ്ടോ എന്ന് നിർണ്ണയിക്കുന്നതുമായ അവസാന വേരിയബിളാണ് ആ അവസാന വേരിയബിൾ.
മികച്ച സംഭാഷണ AI മികച്ച ഡാറ്റയിൽ ആരംഭിക്കുന്നു
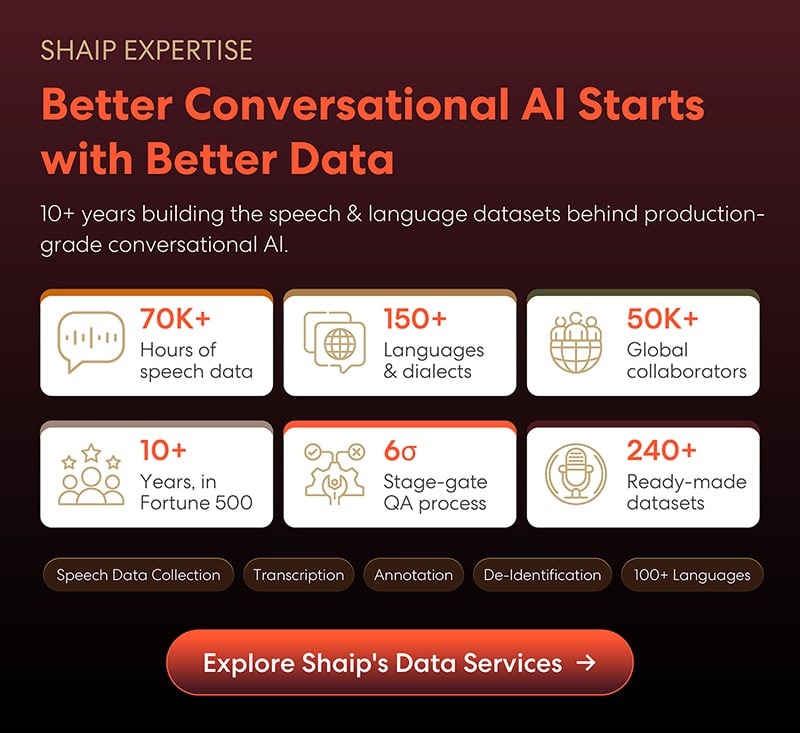
ഒരു വർക്കിംഗ് പ്രോട്ടോടൈപ്പും ഒരു പ്രൊഡക്ഷൻ-ഗ്രേഡ് അസിസ്റ്റന്റും തമ്മിലുള്ള വിടവ് നികത്തുക എന്നത് ഒരു ഡാറ്റ-ഓപ്പറേഷൻ പ്രശ്നമാണ്, കൂടാതെ ഷായിപ് ഒരു ദശാബ്ദത്തിലേറെയായി ഇതിനായി ചെലവഴിച്ചത് ഇതാണ്:
- 70+ മണിക്കൂർ സംഭാഷണ ഡാറ്റയുടെ,
- 150+ ഭാഷകളും ഉപഭാഷകളും,
- 50K+ ആഗോള സഹകാരികൾ,
- 10+ വർഷം ഫോർച്യൂൺ 500 AI ടീമുകളെ സേവിക്കുന്നു,
- a സിക്സ്-സിഗ്മ സ്റ്റേജ്-ഗേറ്റ് ക്യുഎ പ്രക്രിയ,
- 240+ റെഡിമെയ്ഡ് ഡാറ്റാസെറ്റുകൾ ടൈംലൈനുകൾ ആദ്യം മുതൽ ശേഖരിക്കാൻ അനുവദിക്കാത്തപ്പോൾ ഷെൽഫിന് പുറത്ത് ലഭ്യമാകും.
സംഭാഷണ ഡാറ്റ ശേഖരണം, ട്രാൻസ്ക്രിപ്ഷൻ, വ്യാഖ്യാനം, ഡീ-ഐഡന്റിഫിക്കേഷൻ എന്നിവയിലുടനീളം ലക്ഷ്യം ഒന്നുതന്നെയാണ്: നിങ്ങളുടെ ഉൽപ്പന്നം യഥാർത്ഥത്തിൽ സംസാരിക്കുന്ന ആളുകളെ പ്രതിഫലിപ്പിക്കുന്ന പരിശീലന ഡാറ്റ, അത് തെളിയിക്കുന്നതിനുള്ള സമ്മത പാതയും ഗുണനിലവാര മെട്രിക്കുകളും.
താഴത്തെ വരി
സംഭാഷണ AI ഒരു സാങ്കേതിക ചോദ്യമായി നിലച്ചു. ലൂപ്പ് നന്നായി മനസ്സിലാക്കാൻ കഴിയും, മോഡലുകൾ വ്യാപകമായി ലഭ്യമാണ്, ആപ്ലിക്കേഷനുകൾ എല്ലാ വ്യവസായങ്ങളിലുടനീളമുള്ള ബജറ്റുകളിലെ ലൈൻ ഇനങ്ങളാണ്. യഥാർത്ഥത്തിൽ കഠിനമായി അവശേഷിക്കുന്നത് ഡാറ്റ ലെയറാണ് - ലോംഗ്-ടെയിൽ കവറേജ്, ലേബൽ കരാർ, ഡെമോഗ്രാഫിക് ബാലൻസ്, സമ്മതം, ഡി-ഐഡന്റിഫിക്കേഷൻ.
നേട്ടവും അവിടെയാണ്. ഒരേ മോഡൽ ഉപയോഗിക്കുന്ന രണ്ട് ടീമുകൾ വളരെ വ്യത്യസ്തമായ ഗുണനിലവാരമുള്ള ഉൽപ്പന്നങ്ങൾ അയയ്ക്കും, അവരുടെ സിസ്റ്റങ്ങൾ പരിശീലിപ്പിച്ചതിലേക്ക് വിടവ് പിന്തുടരും. നിങ്ങൾ സംഭാഷണപരമായ AI നിർമ്മിക്കുകയാണെങ്കിൽ, നിങ്ങൾ എടുക്കുന്ന ഏറ്റവും നിർണായകമായ തീരുമാനങ്ങൾ വാസ്തുവിദ്യയെക്കുറിച്ചല്ല. അവ നിങ്ങളുടെ ഡാറ്റാസെറ്റിൽ ആരുടെ ശബ്ദങ്ങളാണ്, അവ എത്രത്തോളം ലേബൽ ചെയ്തിരിക്കുന്നു, അവ ഉപയോഗിക്കാൻ നിങ്ങൾക്ക് അവകാശമുണ്ടോ എന്നതിനെക്കുറിച്ചാണ്.