ഓരോ ML എഞ്ചിനീയർമാരും വിശ്വസനീയവും കൃത്യവുമായ ഒരു AI മോഡൽ വികസിപ്പിക്കാൻ ആഗ്രഹിക്കുന്നു. ഡാറ്റാ ശാസ്ത്രജ്ഞർ അവരുടെ സമയത്തിന്റെ ഏകദേശം 80% ഡാറ്റ ലേബൽ ചെയ്യുന്നതിനും വർദ്ധിപ്പിക്കുന്നതിനുമാണ് ചെലവഴിക്കുന്നത് . അതുകൊണ്ടാണ് മോഡലിന്റെ പ്രകടനം അതിനെ പരിശീലിപ്പിക്കാൻ ഉപയോഗിക്കുന്ന ഡാറ്റയുടെ ഗുണനിലവാരത്തെ ആശ്രയിച്ചിരിക്കുന്നത്.
ബിസിനസ്സുകളുടെ വൈവിധ്യമാർന്ന AI പ്രോജക്റ്റ് ആവശ്യങ്ങൾ ഞങ്ങൾ നിറവേറ്റുന്നതിനാൽ, ഞങ്ങളുടെ ബിസിനസ്സ് ക്ലയന്റുകൾ ഞങ്ങളോട് പതിവായി ചോദിക്കുന്ന അല്ലെങ്കിൽ വ്യക്തത ആവശ്യമുള്ള ചില ചോദ്യങ്ങൾ ഞങ്ങൾ കാണുന്നു. അതിനാൽ, ML മോഡലുകളെ കൃത്യമായി പരിശീലിപ്പിക്കുന്നതിന് ഞങ്ങളുടെ വിദഗ്ധ സംഘം സ്വർണ്ണ നിലവാരത്തിലുള്ള പരിശീലന ഡാറ്റ എങ്ങനെ വികസിപ്പിക്കുന്നു എന്നതിന് ഒരു റെഡി റഫറൻസ് നൽകാൻ ഞങ്ങൾ തീരുമാനിച്ചു.
പതിവുചോദ്യങ്ങൾ പരിശോധിക്കുന്നതിനു മുമ്പ്, ഡാറ്റ ലേബലിംഗിന്റെ ചില അടിസ്ഥാന കാര്യങ്ങളും അതിന്റെ പ്രാധാന്യവും നമുക്ക് വിശദീകരിക്കാം .
എന്താണ് ഡാറ്റ ലേബലിംഗ്?
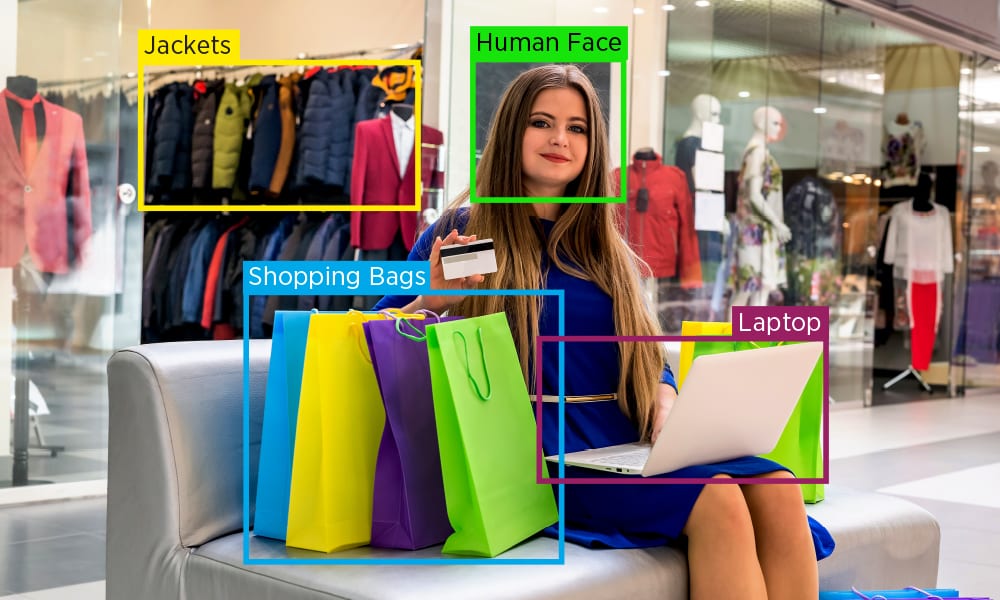
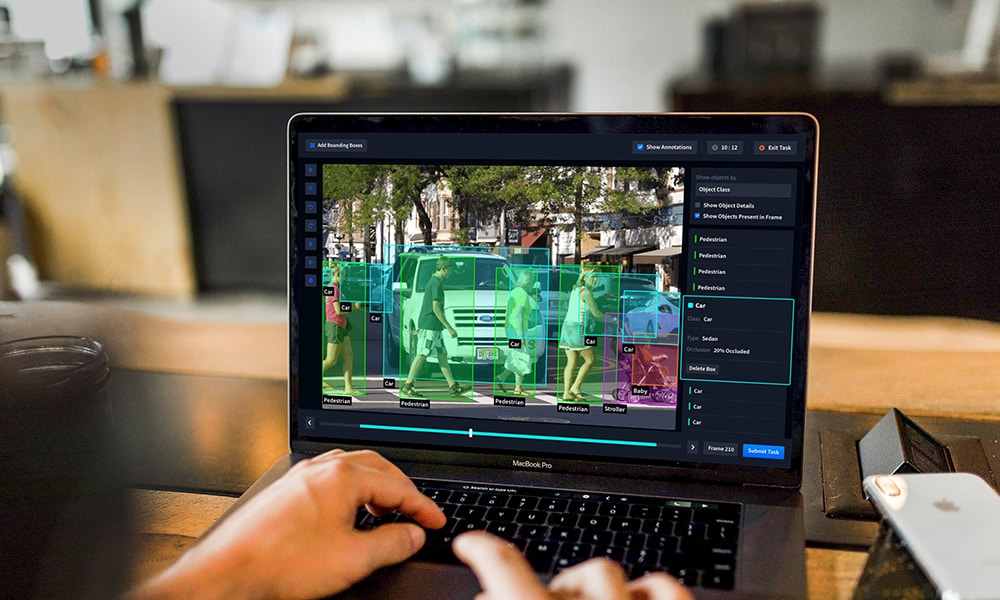
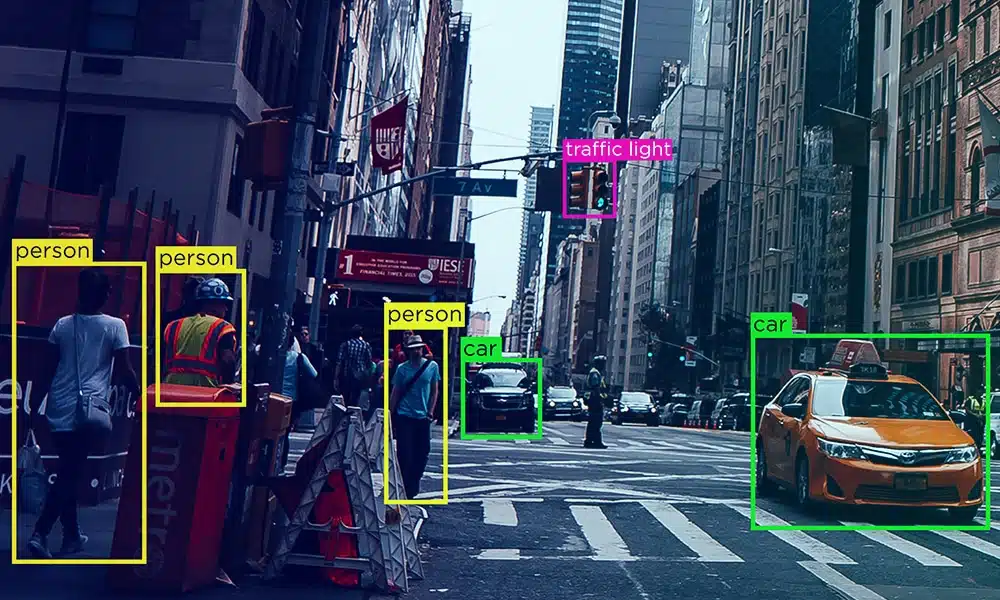
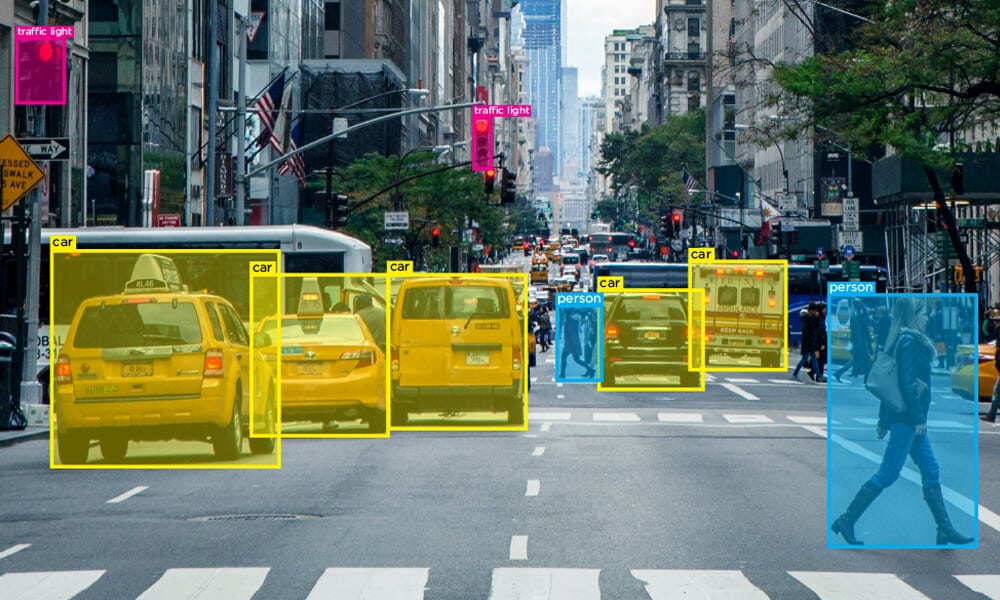
ഇമേജുകൾ, ഓഡിയോ അല്ലെങ്കിൽ വീഡിയോ പോലുള്ള ഡാറ്റ ലേബൽ ചെയ്യുന്നതിനോ ടാഗ് ചെയ്യുന്നതിനോ ഉള്ള പ്രീ-പ്രോസസ്സിംഗ് ഘട്ടമാണ് ഡാറ്റ ലേബലിംഗ്, ഇത് ML മോഡലുകളെ സഹായിക്കുന്നതിനും കൃത്യമായ പ്രവചനങ്ങൾ നടത്താൻ അവരെ പ്രാപ്തമാക്കുന്നതിനും സഹായിക്കുന്നു.
മെഷീൻ ലേണിംഗ് മോഡൽ വികസനത്തിന്റെ പ്രാരംഭ ഘട്ടത്തിൽ ഡാറ്റ ലേബലിംഗ് പരിമിതപ്പെടുത്തേണ്ടതില്ല, എന്നാൽ പ്രവചനങ്ങളുടെ കൃത്യത കൂടുതൽ മെച്ചപ്പെടുത്തുന്നതിന് പോസ്റ്റ് വിന്യാസം തുടരാം.
ഡാറ്റ ലേബലിംഗ് പ്രാധാന്യം

യഥാർത്ഥ ലോക പരിതസ്ഥിതികളെ വിശ്വസനീയമായി മനസ്സിലാക്കാൻ കഴിയുന്ന കൃത്യമായ ഒരു മോഡൽ നിർമ്മിക്കാൻ സഹായിക്കുന്ന ഒരു നിർണായക പ്രീ-പ്രോസസ്സിംഗ് ഘട്ടമാണ് ഡാറ്റ ലേബലിംഗ്. കൃത്യമായി ലേബൽ ചെയ്ത ഡാറ്റാസെറ്റുകൾ കൃത്യമായ പ്രവചനങ്ങളും ഉയർന്ന നിലവാരമുള്ള അൽഗോരിതങ്ങളും ഉറപ്പാക്കുന്നു.
സാധാരണയായി ചോദിക്കുന്ന ചോദ്യങ്ങൾ
വാഗ്ദാനം ചെയ്തതുപോലെ, നിങ്ങൾക്ക് ഉണ്ടാകാവുന്ന എല്ലാ ചോദ്യങ്ങൾക്കും വികസന ജീവിതചക്രത്തിന്റെ ഏത് ഘട്ടത്തിലും നിങ്ങൾക്ക് ഒഴിവാക്കാൻ കഴിയുന്ന തെറ്റുകൾക്കുമുള്ള ഒരു റെഡി റഫറൻസ് ഇതാ.
നിങ്ങൾ എങ്ങനെയാണ് ഡാറ്റയെ അർത്ഥമാക്കുന്നത്?
ഒരു ബിസിനസ്സ് എന്ന നിലയിൽ, നിങ്ങൾ വൻതോതിൽ ഡാറ്റ ശേഖരിച്ചിട്ടുണ്ടാകാം, ഇപ്പോൾ ഡാറ്റയിൽ നിന്ന് പ്രധാന സ്ഥിതിവിവരക്കണക്കുകളോ മൂല്യവത്തായ വിവരങ്ങളോ എക്സ്ട്രാക്റ്റുചെയ്യാൻ നിങ്ങൾ ആഗ്രഹിക്കുന്നു.
പക്ഷേ, നിങ്ങളുടെ പ്രോജക്റ്റ് ആവശ്യകതകളെക്കുറിച്ചോ ബിസിനസ്സ് ലക്ഷ്യങ്ങളെക്കുറിച്ചോ വ്യക്തമായ ധാരണയില്ലാതെ, പരിശീലന ഡാറ്റ പ്രായോഗികമായി ഉപയോഗിക്കാൻ നിങ്ങൾക്ക് കഴിയില്ല. അതിനാൽ പാറ്റേണുകളോ അർത്ഥമോ കണ്ടെത്താൻ നിങ്ങളുടെ ഡാറ്റ അരിച്ചെടുക്കാൻ തുടങ്ങരുത്. പകരം, തെറ്റായ പ്രശ്നങ്ങൾക്ക് പരിഹാരം കണ്ടെത്താതിരിക്കാൻ കൃത്യമായ ലക്ഷ്യത്തോടെ പോകുക.
പരിശീലന ഡാറ്റ പ്രൊഡക്ഷൻ ഡാറ്റയുടെ നല്ല പ്രതിനിധിയാണോ? ഇല്ലെങ്കിൽ, ഞാൻ അത് എങ്ങനെ തിരിച്ചറിയും?
നിങ്ങൾ അത് പരിഗണിച്ചില്ലെങ്കിലും, നിങ്ങളുടെ മോഡലിനെ പരിശീലിപ്പിക്കുന്ന ലേബൽ ചെയ്ത ഡാറ്റ ഉൽപ്പാദന പരിതസ്ഥിതിയിൽ നിന്ന് വളരെ വ്യത്യസ്തമായിരിക്കും.
എങ്ങനെ തിരിച്ചറിയാം? പറയാനുള്ള അടയാളങ്ങൾക്കായി നോക്കുക. നിങ്ങളുടെ മോഡൽ ഒരു പരീക്ഷണ പരിതസ്ഥിതിയിൽ മികച്ച പ്രകടനം കാഴ്ചവച്ചു, ഉൽപ്പാദന സമയത്ത് വളരെ കുറവാണ്.
പരിഹാരം?
കൃത്യമായ ആവശ്യകതകൾ കൃത്യമായി മനസ്സിലാക്കാൻ ബിസിനസുമായോ ഡൊമെയ്ൻ വിദഗ്ധരുമായോ അടിസ്ഥാനം സ്പർശിക്കുക.
-
പക്ഷപാതം എങ്ങനെ ലഘൂകരിക്കാം?
പക്ഷപാതം ലഘൂകരിക്കുന്നതിനുള്ള ഒരേയൊരു പരിഹാരം, നിങ്ങളുടെ മാതൃകയിൽ അവ അവതരിപ്പിക്കുന്നതിന് മുമ്പ് പക്ഷപാതം ഇല്ലാതാക്കുന്നതിൽ സജീവമായിരിക്കുക എന്നതാണ്.
ഡാറ്റാ ബയസ് ഏത് രൂപത്തിലും ആകാം - പ്രതിനിധീകരിക്കാത്ത ഡാറ്റാസെറ്റുകൾ മുതൽ ഫീഡ്ബാക്ക് ലൂപ്പുകളിലെ പ്രശ്നങ്ങൾ വരെ. ഏറ്റവും പുതിയ സംഭവവികാസങ്ങളിൽ നിന്ന് അകന്നുനിൽക്കുന്നതും ശക്തമായ പ്രോസസ് സ്റ്റാൻഡേർഡുകളും ചട്ടക്കൂടുകളും സ്ഥാപിക്കുന്നതും വ്യത്യസ്ത രൂപത്തിലുള്ള പക്ഷപാതത്തെ ചെറുക്കുന്നതിന് അത്യന്താപേക്ഷിതമാണ്.
-
എന്റെ പരിശീലന ഡാറ്റ വ്യാഖ്യാന പ്രക്രിയയ്ക്ക് ഞാൻ എങ്ങനെ മുൻഗണന നൽകും?
ഞങ്ങൾ ചോദിക്കുന്ന ഏറ്റവും സാധാരണമായ ചോദ്യങ്ങളിൽ ഒന്നാണിത് - വ്യാഖ്യാനിക്കുമ്പോൾ ഡാറ്റാസെറ്റിന്റെ ഏത് ഭാഗത്തിനാണ് മുൻഗണന നൽകേണ്ടത്? ഇത് സാധുവായ ഒരു ചോദ്യമാണ്, പ്രത്യേകിച്ചും നിങ്ങൾക്ക് വലിയ ഡാറ്റാസെറ്റുകൾ ഉള്ളപ്പോൾ. നിങ്ങൾ മുഴുവൻ സെറ്റും വ്യാഖ്യാനിക്കേണ്ടതില്ല.
നിങ്ങളുടെ ഡാറ്റാസെറ്റിന്റെ ഒരു നിർദ്ദിഷ്ട ഭാഗം തിരഞ്ഞെടുക്കാനും ക്ലസ്റ്റർ ചെയ്യാനും സഹായിക്കുന്ന വിപുലമായ സാങ്കേതിക വിദ്യകൾ നിങ്ങൾക്ക് ഉപയോഗിക്കാം, അതുവഴി വ്യാഖ്യാനത്തിനായി ആവശ്യമായ ഡാറ്റയുടെ ഉപസെറ്റ് മാത്രം അയയ്ക്കും. ഈ രീതിയിൽ, നിങ്ങളുടെ മോഡലിന്റെ വിജയത്തെക്കുറിച്ചുള്ള ഏറ്റവും നിർണായകമായ വിവരങ്ങൾ നിങ്ങൾക്ക് അയയ്ക്കാൻ കഴിയും.
-
അസാധാരണമായ സന്ദർഭങ്ങളിൽ ഞാൻ എങ്ങനെ പ്രവർത്തിക്കും?
അസാധാരണമായ കേസുകൾ കൈകാര്യം ചെയ്യുന്നത് ഓരോ ML മോഡലിനും വെല്ലുവിളിയായേക്കാം. മോഡൽ സാങ്കേതികമായി പ്രവർത്തിക്കുമെങ്കിലും, നിങ്ങളുടെ ബിസിനസ്സ് ആവശ്യങ്ങൾ നിറവേറ്റുമ്പോൾ അത് ഡീൽ വെട്ടിക്കുറച്ചേക്കില്ല.

ഈ വെല്ലുവിളിയെ നേരിടാൻ, മനുഷ്യർ ഉൾപ്പെടുന്ന ഫീഡ്ബാക്കും മേൽനോട്ടത്തിലുള്ള പഠനവും നിർണായകമാണ്. സമാന ഇമേജുകൾ ശേഖരിക്കുന്നതിന് മുഴുവൻ ഡാറ്റാസെറ്റിലൂടെയും സമാനത തിരയലും ഫിൽട്ടറും ഉപയോഗിക്കുന്നതാണ് പരിഹാരം. ഇതുപയോഗിച്ച്, സമാന ഇമേജുകളുടെ ഉപസെറ്റ് മാത്രം വ്യാഖ്യാനിക്കുന്നതിൽ ശ്രദ്ധ കേന്ദ്രീകരിക്കാനും ഹ്യൂമൻ-ഇൻ-ദി-ലൂപ്പ് രീതി ഉപയോഗിച്ച് അത് മെച്ചപ്പെടുത്താനും കഴിയും.
-
ഞാൻ അറിഞ്ഞിരിക്കേണ്ട ഏതെങ്കിലും പ്രത്യേക ലേബലുകൾ ഉണ്ടോ?
നിങ്ങളുടെ ചിത്രങ്ങൾക്കായി ഏറ്റവും വിശദമായ ലേബലിംഗ് നൽകാൻ നിങ്ങൾ പ്രലോഭിപ്പിച്ചേക്കാം എങ്കിലും, അത് എല്ലായ്പ്പോഴും ആവശ്യമോ അനുയോജ്യമോ ആയിരിക്കണമെന്നില്ല. ഓരോ ചിത്രത്തിനും ഒരു ഗ്രാനുലാർ തലത്തിലുള്ള വിശദാംശങ്ങളും കൃത്യതയും നൽകാൻ എടുക്കുന്ന സമയവും ചെലവും നേടാൻ പ്രയാസമാണ്.
മോഡൽ ആവശ്യകതകളിൽ നിങ്ങൾക്ക് വ്യക്തതയുണ്ടെങ്കിൽ, ഓവർ-പ്രിസ്ക്രിപ്റ്റീവ് ആയിരിക്കുകയോ ഡാറ്റ വ്യാഖ്യാനത്തിൽ ഏറ്റവും ഉയർന്ന കൃത്യത ആവശ്യപ്പെടുകയോ ചെയ്യുന്നത് നിർദ്ദേശിക്കപ്പെടുന്നു.
-
എഡ്ജ് കേസുകൾ നിങ്ങൾ എങ്ങനെയാണ് കണക്കാക്കുന്നത്?
നിങ്ങളുടെ ഡാറ്റ വ്യാഖ്യാന തന്ത്രം തയ്യാറാക്കുമ്പോൾ എഡ്ജ് കേസുകൾക്കുള്ള അക്കൗണ്ട്. എന്നിരുന്നാലും, നിങ്ങൾ നേരിട്ടേക്കാവുന്ന എല്ലാ എഡ്ജ് കേസും മുൻകൂട്ടി കാണുന്നത് അസാധ്യമാണെന്ന് നിങ്ങൾ ആദ്യം മനസ്സിലാക്കണം. പകരം, നിങ്ങൾക്ക് വേരിയബിലിറ്റി ശ്രേണിയും തന്ത്രവും തിരഞ്ഞെടുക്കാം, അത് എഡ്ജ് കേസുകൾ ക്രോപ്പ് അപ്പ് ചെയ്യുമ്പോൾ കണ്ടെത്താനും കൃത്യസമയത്ത് അവ പരിഹരിക്കാനും കഴിയും.
-
എനിക്ക് ഏത് വിധത്തിലാണ് ഡാറ്റ അവ്യക്തത കൈകാര്യം ചെയ്യാൻ കഴിയുക?
ഡാറ്റാസെറ്റിലെ അവ്യക്തത വളരെ സാധാരണമാണ്, കൃത്യമായ വ്യാഖ്യാനത്തിനായി അത് എങ്ങനെ കൈകാര്യം ചെയ്യണമെന്ന് നിങ്ങൾ അറിഞ്ഞിരിക്കണം. ഉദാഹരണത്തിന്, പകുതി പഴുത്ത ആപ്പിളിന്റെ ചിത്രം പച്ച ആപ്പിളോ ചുവന്ന ആപ്പിളോ ആയി ലേബൽ ചെയ്യാം.
അത്തരം അവ്യക്തത പരിഹരിക്കുന്നതിനുള്ള താക്കോലിന് തുടക്കം മുതലുള്ള വ്യക്തമായ നിർദ്ദേശങ്ങളുണ്ട്. ആദ്യം, വ്യാഖ്യാനകരും വിഷയ വിദഗ്ധരും തമ്മിലുള്ള നിരന്തരമായ ആശയവിനിമയം ഉറപ്പാക്കുക. അത്തരം അവ്യക്തത മുൻകൂട്ടി കണ്ടുകൊണ്ടും തൊഴിൽ ശക്തിയിലുടനീളം നടപ്പിലാക്കാൻ കഴിയുന്ന മാനദണ്ഡങ്ങൾ നിർവചിച്ചുകൊണ്ടും ഒരു സ്റ്റാൻഡേർഡ് റൂൾ ഉണ്ടായിരിക്കുക.
-
ഉൽപ്പാദനത്തിൽ മോഡൽ പ്രകടനം മെച്ചപ്പെടുത്താൻ എന്തെങ്കിലും വഴികളുണ്ടോ?
ടെസ്റ്റിംഗ് പരിതസ്ഥിതിയും പ്രൊഡക്ഷൻ ഡാറ്റയും വ്യത്യസ്തമായതിനാൽ, കുറച്ച് സമയത്തിന് ശേഷം പ്രകടനത്തിൽ വ്യതിയാനങ്ങൾ ഉണ്ടാകും. പരിശീലന സമയത്ത് ഒരു മോഡൽ അത് വെളിപ്പെടുത്താത്ത കാര്യങ്ങൾ പഠിക്കുമെന്ന് നിങ്ങൾക്ക് പ്രതീക്ഷിക്കാനാവില്ല.
മാറിക്കൊണ്ടിരിക്കുന്ന പ്രൊഡക്ഷൻ ഡാറ്റയുമായി ടെസ്റ്റിംഗ് ഡാറ്റ പൊരുത്തപ്പെടുത്താൻ ശ്രമിക്കുക. ഉദാഹരണത്തിന്, നിങ്ങളുടെ മോഡലിനെ വീണ്ടും പരിശീലിപ്പിക്കുക, മനുഷ്യ ലേബലർമാരെ ഉൾപ്പെടുത്തുക , കൂടുതൽ കൃത്യവും പ്രതിനിധാനപരവുമായ സാഹചര്യങ്ങൾ ഉപയോഗിച്ച് ഡാറ്റ മെച്ചപ്പെടുത്തുക, വീണ്ടും പരിശോധിച്ച് ഉൽപാദനത്തിൽ ഉപയോഗിക്കുക.
-
പരിശീലന ഡാറ്റ ആവശ്യകതകളുടെ വ്യാഖ്യാനത്തിനായി ഞാൻ ആരെയാണ് സമീപിക്കേണ്ടത്?
ML മോഡലുകൾ വികസിപ്പിക്കുന്നതിലൂടെ എല്ലാ ബിസിനസ്സിനും എന്തെങ്കിലും നേട്ടമുണ്ടാകും. അസംസ്കൃത ഡാറ്റയെ വിലപ്പെട്ട ഉൾക്കാഴ്ചയാക്കി മാറ്റുന്നതിന് എല്ലാ ബിസിനസ് സ്ഥാപനങ്ങൾക്കും സാങ്കേതിക പരിജ്ഞാനമോ വിദഗ്ദ്ധ ഡാറ്റ ലേബലിംഗ് ടീമുകളോ ഇല്ല . മത്സരപരമായ നേട്ടം നേടുന്നതിന് നിങ്ങൾക്ക് അത് ഉപയോഗിക്കാൻ കഴിയണം.
വശങ്ങൾ ഉണ്ടെങ്കിലും, നിങ്ങൾ ഒരു ഡാറ്റ പരിശീലന പങ്കാളിയിൽ തിരയുന്നുണ്ടാകാം, വിശ്വാസ്യത, അനുഭവം, വിഷയ പരിജ്ഞാനം എന്നിവ ഓർമ്മിക്കേണ്ട പ്രധാന മൂന്ന് പോയിന്റുകളിൽ ചിലതാണ്. വിശ്വസനീയമായ ഒരു മൂന്നാം കക്ഷി സേവന ദാതാവിലേക്ക് പോകുന്നതിന് മുമ്പ് ഇവ പരിഗണിക്കുക.
കൃത്യവും വിശ്വസനീയവുമായ ഡാറ്റ ലേബലിംഗ് സേവന ദാതാക്കളുടെ പട്ടികയിൽ മുന്നിൽ നിൽക്കുന്നത് Shaip ആണ്. നിങ്ങളുടെ എല്ലാ ലേബലിംഗിനും ഡാറ്റ അനോട്ടേഷൻ ആവശ്യങ്ങൾക്കും ഞങ്ങൾ വിപുലമായ അനലിറ്റിക്സ്, അനുഭവ ടീമുകൾ, വിഷയ വിദഗ്ദ്ധർ എന്നിവരെ ഉപയോഗിക്കുന്നു . മാത്രമല്ല, മുൻനിര ബിസിനസുകൾക്കായി ടോപ്പ്-എൻഡ് അനോട്ടേഷൻ, ലേബലിംഗ് പ്രോജക്ടുകൾ വികസിപ്പിക്കാൻ ഞങ്ങളെ സഹായിച്ച ഒരു സ്റ്റാൻഡേർഡ് നടപടിക്രമം ഞങ്ങൾ പിന്തുടരുന്നു.